
KI-Sichtbarkeit messen: Die 5 Fehler, die fast jedes Team beim Einstieg macht
Wer anfängt, die eigene Marke in ChatGPT, Perplexity oder dem Google AI Mode zu messen, stolpert an fünf immer gleichen Stellen: Prompt-Set, Ziel, Segmente, Nische und Reihenfolge der Maßnahmen. Jede davon lässt sich vermeiden, bevor der erste Report entsteht.
Frage, wie Ihre Kunden sie stellen
Worauf sollte man bei HR-Software für 80 Mitarbeitende achten?
Ohne Markennamen in der Frage


 Prompt speichern
Abdeckung des Sets
32 Prompts
Nach Stufe
EinstiegAuswahlVergleichEntscheidung
Nach Persona
- Geschäftsführung6
- HR-Leitung12
- Lohnbuchhaltung13
- IT1
Persona IT kaum abgedeckt
28 von 32 ohne Markennamen
Ziel der Messung
Mention-First
Share of Prompts mit Nennung von Kanto HR, im Vergleich zu Velora und Brightpay
Beispieldaten
Das Titelbild zeigt einen Prompt, wie er ins Set gehört: mit Persona, Stufe und Produktlinie, ohne Markennamen und mit einem festgelegten Ziel.
Die Messung von KI-Sichtbarkeit ist ein junges Feld, und das merkt man den Setups an. Ein Team bekommt Budget für eine Monitoring-Plattform, legt am ersten Tag dreißig Prompts an, exportiert zwei Wochen später den ersten Report und stellt fest, dass sich daraus keine einzige Entscheidung ableiten lässt. Das liegt selten am Werkzeug. Es liegt daran, dass das Fundament schief steht.
Antworten aus ChatGPT, Perplexity oder dem Google AI Mode sind für viele Käufer inzwischen der Ort, an dem Empfehlungen, Anbietervergleiche und Produktinformationen zusammenlaufen. Entsprechend fließt Geld in Tracking-Setups. Was am Ende an Erkenntnis herauskommt, hängt aber weniger an der Plattform als an ein paar Entscheidungen, die vor der ersten Messung fallen. Fünf davon gehen beim Einstieg regelmäßig schief.
Ich gehe sie der Reihe nach durch: vom Prompt-Set, das Ihr Geschäft abbilden muss, über die Frage, was Erfolg für Sie überhaupt bedeutet, bis zu der Reihenfolge, in der Sie nach dem ersten Report tatsächlich anfangen sollten.
Fehler 1: Warum steht und fällt die Messung der KI-Sichtbarkeit mit dem Prompt-Set?
Das Prompt-Set ist die Basis aller späteren Entscheidungen. Alles, was eine Monitoring-Plattform Ihnen anzeigt, ist eine Auswertung der Fragen, die Sie ihr vorgegeben haben. Bilden diese Fragen Ihre Geschäftsrealität nicht präzise ab, ist jede darauf aufbauende Analyse verzerrt, und zwar von Anfang an und ohne dass es im Dashboard sichtbar wird. Falsch kalibrierte Prompts liefern Erkenntnisse zu einem Markt, der nicht Ihrer ist. Jede Entscheidung auf Basis dieser Daten trifft einen Markt, den es so nicht gibt.
Was macht ein gutes Prompt-Set aus?
Drei Eigenschaften. Es ist vielfältig, es ist sorgfältig formuliert, und es deckt das gesamte Spektrum ab, in dem Menschen KI-Systeme zu Ihrem Themenfeld befragen. Dazu gehören unterschiedliche Suchabsichten genauso wie unterschiedliche Frageformate. Wer eine Kategorie erst kennenlernt, formuliert anders als jemand, der zwischen zwei Anbietern schwankt, und beide Formulierungen erzeugen völlig verschiedene Antworten.
Die Sorgfalt in der Formulierung wird dabei am häufigsten unterschätzt. Ein Prompt ist kein Keyword. Er ist ein Satz, und kleine Verschiebungen in diesem Satz verschieben die Antwort mit. Wer sein Set aus einer Keyword-Liste ableitet und Fragezeichen anhängt, misst am Ende, wie ein Sprachmodell auf Suchbegriffe reagiert, nicht wie es auf Kunden reagiert.
Woher kommen die richtigen Prompts?
Aus dem Wissen im eigenen Haus, nicht aus einem Keyword-Tool. Drei Quellen tragen den Aufbau:
- Buyer Personas. Wer fragt die KI überhaupt? Mit welchem Hintergrund, in welcher Rolle, mit welchem Wissensstand? Eine technische Fachrolle und eine Einkaufsentscheiderin stellen zur selben Software unterschiedliche Fragen, und die Antworten unterscheiden sich entsprechend.
- Produktlinien und Features. Welche Angebote sind strategisch wichtig? Welche Unterseiten, Produktnamen und Feature-Begriffe gehören deshalb ins Set? Ein Set, das nur die Dachmarke abfragt, sagt Ihnen nichts über die Linie, die im nächsten Quartal wachsen soll.
- Awareness-Stufen. Das Set muss den kompletten Bogen abdecken, von Menschen, die nicht einmal wissen, dass die Kategorie existiert, bis zu Menschen, die Ihre Marke direkt mit einem Wettbewerber vergleichen.
Konkret heißt das: Grundsatzfragen zur Kategorie wie „Was ist …?“ oder „Worauf sollte man achten bei …?“ gehören genauso ins Set wie konkrete Produkt- und Anbietervergleiche. Fehlt das eine Ende, sehen Sie nur noch, wie Sie in bereits laufenden Entscheidungen abschneiden. Fehlt das andere, wissen Sie nie, ob Sie in der engeren Auswahl überhaupt vorkommen.
Warum brauchen Prompts eine Tagging-Struktur?
Weil ein Prompt-Set ohne Kategorien später nicht auswertbar ist. Prompts gehören organisiert, mit Tags nach Thema, Persona, Produktlinie oder einer Kombination daraus. Liegen alle Prompts in einer einzigen flachen Liste, wird es später sehr schwer, daraus Erkenntnisse zu ziehen. Mit Tags können Sie filtern und schneiden, und genau das macht den Unterschied.
| Prompt | Persona | Stufe | Linie |
|---|---|---|---|
| Was kostet eine Software für die Lohnabrechnung im Mittelstand? | Geschäftsführung | Einstieg | Lohn |
| Worauf sollte man bei HR-Software für 50 bis 200 Mitarbeitende achten? | HR-Leitung | Einstieg | Plattform |
| Welche HR-Software lässt sich an DATEV anbinden? | Lohnbuchhaltung | Auswahl | Lohn |
| Velora oder Brightpay für ein Team mit Schichtbetrieb? | HR-Leitung | Vergleich | Zeit |
| Hat Kanto HR eine Schnittstelle zu Microsoft Entra?mit Markenname | IT | Entscheidung | Plattform |
Beispieldaten · 5 von 32 Prompts
Der Aufwand fällt einmal an, beim Anlegen. Nachträglich zu taggen ist mühsam, weil dann bereits Wochen an Messdaten an Prompts hängen, deren Zuordnung Sie im Nachhinein rekonstruieren müssen. Diese halbe Stunde am Anfang entscheidet darüber, ob der Datensatz in drei Monaten segmentierbar ist.
Wie viele Prompts sollten ohne Ihren Markennamen laufen?
Ein häufiges Versäumnis beim Einstieg: Es werden ausschließlich Prompts gemessen, die den eigenen Markennamen enthalten. Das fühlt sich naheliegend an und erzeugt schnell gute Zahlen. Nur sehen Sie damit nie die Wettbewerber. Steht Ihr Name in der Frage, spricht die KI fast zwangsläufig über Sie.
Prompts ohne Markennamen sind die eigentliche Bewährungsprobe. Sie messen, ob die KI Ihre Marke empfiehlt, wenn jemand eine allgemeine Frage zur Kategorie stellt. Genau das ist der Test: Empfiehlt die KI Sie, wenn Ihr Name nicht in der Frage steht? Ein großer Teil des Sets muss deshalb ohne Markennamen auskommen.
Wenn Sie das Set nicht auf einer leeren Seite aufbauen wollen, hilft ein Blick darauf, wie die Prompt-Messung in Sotiq aufgebaut ist. Die Struktur dort ist dieselbe, die Sie für Ihr eigenes Set brauchen.
Fehler 2: Was bedeutet gute KI-Sichtbarkeit für Ihr Geschäftsmodell?
Es gibt darauf keine allgemeingültige Antwort, und das ist der Kern des zweiten Fehlers. Unterschiedliche Unternehmen brauchen abhängig von ihrer Nische und ihrem Geschäftsmodell völlig unterschiedliche Ziele. Wer diese Frage nicht vorab klärt, misst am Ende die falschen Kennzahlen, und zwar sehr genau. Zwei grundlegende Strategien lassen sich unterscheiden.
Wann ist Citation-First die richtige Strategie?
Immer dann, wenn die Zitation selbst der Wert ist. Das klarste Beispiel ist eine Online-Publikation, die Unterhaltungselektronik testet, also Laptops und Smartphones. Ihr Geschäftsmodell beruht darauf, gegenüber Marken nachzuweisen, dass ihre Tests von KI-Systemen zitiert werden.
Fragt jemand ChatGPT „Was ist der beste Laptop für Videobearbeitung?“ und der Test dieser Publikation erscheint als zitierte Quelle, ist das für sie unmittelbar Geld wert. Laptop-Hersteller wollen auf dieser Publikation präsent sein, weil sie wissen, dass deren Tests in KI-Antworten als Quelle auftauchen. Die Zitation ist hier kein Zwischenschritt zum Umsatz, sie ist das Produkt.
Entsprechend liegen die Kennzahlen fest: die Anzahl der Citations, also wie oft die eigene Quelle zitiert wird. Der Citation Share, also der eigene Anteil an allen Zitationen im Vergleich zu konkurrierenden Publikationen. Und die Citation Rate, also bei wie vielen der relevanten Prompts die eigene Quelle überhaupt auftaucht. Welche Seiten die Modelle zu Ihren Fragen zitieren, zeigt die Quellen-Analyse.
Wann ist Mention-First die richtige Strategie?
Für Software- und Produktmarken. Das Ziel ist hier nicht die zitierte Quelle, sondern der Markenname in der KI-Antwort selbst. Jemand fragt ChatGPT nach einer Empfehlung für ein Projektmanagement-Tool, und die Marke will in dieser Antwort genannt werden.
Eine Feinheit ist dabei wichtig, weil sie in der Praxis regelmäßig für Verwirrung sorgt: Eine Marke kann in einer KI-Antwort erwähnt werden, ohne dass ihr eigener Content zitiert oder gerankt wird. Die Erwähnung kann vollständig auf Drittquellen beruhen, auf Bewertungen oder auf Branchenübersichten. Wer nur die eigene Domain im Blick hat, sieht in diesem Fall gar nichts, obwohl die Marke sichtbar ist.
Die Kennzahlen sehen entsprechend anders aus: die Anzahl der Mentions, der Share of Prompts mit Markennennung, also bei wie vielen der relevanten Prompts die Marke auftaucht, und die Entwicklung im Zeitverlauf im Vergleich zu Wettbewerbern. Der letzte Punkt trägt am meisten. Ob Ihre Sichtbarkeit steigt oder fällt, sagt für sich genommen wenig, solange Sie nicht wissen, ob sich der Wettbewerb in dieselbe Richtung bewegt.
Was ändert die Unterscheidung im Reporting?
Sie macht es aussagekräftig. Mit definiertem Ziel wissen Sie genau, welche Kennzahlen Sie messen müssen, und genauso wichtig: welche nicht. Ein Report, der Citations und Mentions nebeneinanderstellt, ohne zu sagen, welche der beiden Zahlen die Zielgröße ist, erzeugt in jedem Termin mit der Geschäftsführung dieselbe Rückfrage.
Fehler 3: Warum verdecken Gesamtzahlen die eigentlichen Erkenntnisse?
Beim Einstieg in eine Plattform für KI-Sichtbarkeit ist die Versuchung groß, alles als Gesamtwert zu betrachten. Gesamt-Citations, Gesamt-Mentions, allgemeine Trends. Das sind die Zahlen, die im Dashboard oben stehen, und sie lassen sich bequem in eine Folie übertragen. Nur verdecken sie genau das, wofür Sie gemessen haben. Die eigentlichen Erkenntnisse entstehen erst durch Filtern und Segmentieren.
Warum lässt sich die Frage nach den wichtigsten Quellen nicht pauschal beantworten?
Weil sie vom Thema abhängt. Die wichtigsten Quellen unterscheiden sich stark je nach Thema. Eine Quelle, aus der die KI bei einem Ihrer Themen ständig schöpft, kann bei einem anderen Thema komplett fehlen. Die Gesamtliste der zehn wichtigsten Quellen über alle Prompts hinweg mittelt genau diese Unterschiede weg und sagt am Ende wenig aus.
In der Praxis führt das zu einer typischen Fehlentscheidung: Ein Team liest die Gesamtliste der Quellen, sucht sich die drei Publikationen ganz oben heraus und startet dort Outreach. Dass diese drei ihre Spitzenposition einem Themenbereich verdanken, der für das Geschäft am Rand liegt, geht in der Gesamtzahl unter.
Wie sieht eine Erkenntnis aus, mit der man arbeiten kann?
Sie ist gefiltert. Nach Thema, nach Persona, nach Produktkategorie oder nach einer Kombination daraus. Statt „Das sind die zehn wichtigsten Quellen insgesamt“ lautet die wertvolle Erkenntnis dann: „Für genau dieses Thema, das für mein Geschäft zählt, sind das die drei Quellen mit Kaufabsicht, aus denen die KI ständig schöpft.“ Das ist ein grundlegend anderer und viel nützlicherer Befund, weil daraus unmittelbar eine Aufgabenliste wird.
Damit schließt sich der Kreis zum ersten Fehler. Diese Art der Segmentierung funktioniert nur, wenn das Prompt-Set korrekt getaggt ist. Ohne saubere Tags gibt es keine Schnitte, nach denen sich filtern ließe, und die Daten bleiben auf der Ebene der Gesamtzahl stehen, ob Sie wollen oder nicht. Genau deshalb ist ein korrekt getaggtes Prompt-Set der erste Schritt.
Fehler 4: Warum funktionieren Best Practices aus anderen Nischen bei Ihnen nicht?
Weil Erkenntnisse aus der KI-Suche stark von der Nische abhängen. Was in einer Nische funktioniert, funktioniert nicht automatisch in einer anderen, und die richtigen Schlüsse hängen vollständig davon ab, was die Daten in Ihrer Branche zeigen. Einen universellen Ansatz gibt es nicht, auch wenn die Menge an veröffentlichten Empfehlungen etwas anderes nahelegt.
Warum ist eine Nische mit wenig Inhalten wie Cybersecurity eine Chance?
Cybersecurity ist ein gutes Beispiel für eine Nische mit wenig Inhalten und hoher Einstiegshürde. Die Expertise, die nötig ist, um glaubwürdige Inhalte zu komplexen Themen wie Endpoint Detection oder Zero-Trust-Architektur zu erstellen, ist hoch. Allgemeine Blogbeiträge werden in diesem Umfeld nicht zitiert. Entsprechend gibt es deutlich weniger Inhalte als in Massenmärkten.
Daraus entsteht eine echte Chance. Weil es weniger Inhalte gibt und die Qualitätshürde hoch ist, kann eine Marke in diesem Bereich schneller zu einer ständig zitierten Quelle werden, als man erwarten würde. Die Konkurrenz um Zitationen ist dünner. Der Content, der zitiert wird, muss dafür substanziell und fundiert sein, und genau das ist der Preis für die dünnere Konkurrenz.
Was ist in Nischen mit vielen Inhalten anders?
Praktisch alles. In Beauty, Mode oder Lifestyle konkurrieren tausende Blogs, Influencer-Seiten und Testportale um dieselben Prompts. Die Lage ist eine völlig andere: hohe Dichte, starker Wettbewerb, andere Regeln bei der Auswahl der Quellen. Eine Strategie, die in Cybersecurity trägt, weil dort wenige substanzielle Quellen existieren, läuft hier gegen eine Wand aus Inhalten, die alle dasselbe sagen.
Für Ihre eigene Analyse folgt daraus eine unbequeme Regel: Beim Lesen der Daten helfen allgemeine Best Practices nicht weiter. Schauen Sie sich an, was die Daten in Ihrer Nische sagen, und bauen Sie die Strategie darauf auf. Welche Angaben über Ihre Marke die Modelle aus den Quellen Ihres Felds übernehmen, zeigt Brand Discovery deutlich zuverlässiger als jede Branchenempfehlung.
Fehler 5: Womit fangen Sie nach dem ersten Report an?
Das typische Muster: Ein Team richtet die Messung ein, bekommt den ersten Report und glaubt, jetzt müsse sofort die gesamte Website umgebaut werden. In Wahrheit ist ein Website-Redesign so gut wie nie der richtige erste Schritt. Es ist die teuerste und langsamste Maßnahme in einem Feld, in dem es wirkungsvollere Hebel gibt, die ganz ohne Änderungen an der eigenen Website auskommen.
Hilfreicher ist eine Reihenfolge mit vier Stufen. Die Reihenfolge ist dabei kein Vorschlag, sondern die eigentliche Aussage: Sie führt von dem, was außerhalb Ihrer Website passiert, zu dem, was Sie selbst schreiben müssen.
Ohne Änderung an der Website
- Stufe 1In zitierten Quellen vorkommenomr.de und capterra.com.de nennen Velora und Brightpay, Kanto HR fehltE-Mail, Gespräch
- Stufe 2Falsche Angabe korrigieren lassenEin Vergleichsportal schreibt, Kanto HR habe kein Single Sign-oneine Anfrage
An der eigenen Website
- Stufe 3Kernseiten vollständig machenPreisseite, Über uns, Seite zur DATEV-Anbindungdrei Seiten
- Stufe 4Kaufratgeber schreibenWorauf achten bei HR-Software für 50 bis 200 Mitarbeitende?ein Artikel
Beispieldaten
Stufe 1: Welche Quellen zitiert die KI schon, ohne Sie zu nennen?
Der Ausgangspunkt ist eine Liste: Welche Quellen werden in KI-Antworten für Ihre relevanten Prompts bereits zitiert? Kommt Ihre Marke in diesen Quellen nicht vor, haben Sie damit Ihre Outreach-Liste. Diese Websites und Publikationen genießen für Ihr Thema bereits das Vertrauen der KI. Eine Erwähnung in einer von ihnen zu bekommen, ist einer der wirkungsvollsten Hebel überhaupt, und er kostet keine einzige Zeile Code auf der eigenen Seite.
Plattformen mit einer Lückenanalyse zeigen genau das an: welche Quellen zitiert werden und wo die eigene Marke darin fehlt. Wenn Sie wissen wollen, wer an Ihrer Stelle in diesen Quellen steht, gehört eine laufende Wettbewerbsanalyse in KI-Antworten mit auf die Liste.
Stufe 2: Was steht falsch über Sie in fremden Quellen?
Taucht Ihre Marke in zitierten Quellen bereits auf, ist die nächste Frage, ob die Darstellung dort korrekt und aktuell ist. Ein Beispiel aus der Praxis: Eine Drittquelle behauptet, eine Marke habe kein Single Sign-on, obwohl das Feature längst angeboten wird. Die KI übernimmt diese falsche Information, und sie schadet der Marke genau an der Stelle, an der jemand gerade zwischen zwei Anbietern abwägt.
Eine einfache Korrekturanfrage an die Quelle kann das beheben. Der Aufwand ist eine E-Mail, die Wirkung reicht bis in jede Antwort, die sich auf diese Quelle stützt. Mit laufender Messung lassen sich solche Fälle regelmäßig aufdecken, statt zufällig darüber zu stolpern.
Stufe 3: Welche eigenen Seiten sind wirklich kritisch?
Erst hier kommt die eigene Website ins Spiel, und auch dann gilt: nicht alles auf einmal anfassen. Der Fokus liegt auf den wichtigsten Seiten, also auf Preisseiten, Über-uns-Seiten und Seiten zu Produkten und Funktionen. Der Grund: Für genau diese Art spezifischer Angaben greifen KI-Modelle oft direkt auf die Website der Marke zurück.
Für diese Seiten gelten damit andere Anforderungen als für den Rest. Sie müssen gut gegliedert sein, sie müssen vollständig sein, und die KI muss sie leicht lesen können. Eine Preisseite, die ihre Konditionen nur in einer Grafik zeigt, fällt an genau dieser Stelle durch. Solche Seiten überarbeitet Sam in Sotiq als Entwurf, den Sie freigeben.
Stufe 4: Warum eignen sich Kaufratgeber so gut als Quelle?
Die vierte Stufe geht einen Schritt weiter und erstellt Inhalte, die Kaufentscheidungen begleiten. Das konkrete Format ist der Kaufratgeber: „Worauf sollte man achten, wenn man ein Produkt in dieser Kategorie auswählt?“ Ihre eigenen Funktionen und Unterschiede werden dabei in ein sachliches, hilfreiches Format eingebettet, statt als Verkaufsargument dazustehen.
Der Grund liegt im Rechercheverhalten der Modelle: Sprachmodelle suchen für ihre Antworten nach sachlichen, vollständigen, gut gegliederten Texten. Entspricht Ihr Inhalt diesen Kriterien, kann er zur bevorzugten Quelle für eine ganze Frage zur Kategorie werden. Welche Arten solcher Texte Sam schreibt, zeigen Sams Assistenten.
Warum ist die Reihenfolge der vier Stufen so wichtig?
Weil die ersten beiden Stufen keine einzige Änderung an Ihrer Website erfordern. Sie nutzen Quellen, die bereits existieren und bereits zitiert werden, und sie korrigieren Informationen, die bereits im Umlauf sind. Beides ist schnell umsetzbar, braucht kein Entwicklungsbudget und wirkt an der Stelle, an der die KI ihre Antwort tatsächlich zusammensetzt.
Erst danach kommt die Arbeit an der eigenen Seite, und auch dann gezielt an den kritischen Seiten statt an allem. Wer diese Reihenfolge umdreht, beginnt mit der Maßnahme, die am längsten dauert, am meisten kostet und am schwersten zu bewerten ist. Haben Sie noch gar keine Ausgangsmessung, fangen Sie eine Stufe davor an: Der Minicheck für eine Domain zeigt in wenigen Minuten, bei welchen Prompts die Marke genannt wird und wer stattdessen empfohlen wird. Welche Maßnahmen in KI-Antworten messbar gewirkt haben und welche nur laut waren, steht in der Bilanz aus einem Jahr KI-Suche.
Kurz beantwortet.
Vier Fragen, die vor dem ersten Report fast immer kommen.
Ein Set für die Messung der KI-Sichtbarkeit braucht so viele Prompts, dass jede Persona, jede wichtige Produktlinie und jede Stufe vom Einstieg bis zum Anbietervergleich vertreten ist. Dreißig durchdachte, sauber getaggte Prompts sagen mehr als dreihundert in einer flachen Liste. In Sotiq trägt jeder Prompt seine Tags, damit sich die Ergebnisse später nach Persona, Stufe und Produktlinie filtern lassen.
Eine Citation ist der Verweis einer KI-Antwort auf eine Quelle, also auf eine URL, eine Mention ist die Nennung einer Marke im Antworttext selbst. Beides tritt unabhängig voneinander auf: Eine Marke kann empfohlen werden, ohne dass ihre Website zitiert wird, weil die Empfehlung aus Bewertungen oder Branchenübersichten stammt. Sotiq zeigt Nennungen und zitierte Quellen getrennt, damit ein Team die Zahl liest, die zu seinem Ziel passt.
Prompts ohne Markennamen gehören in jedes Set, weil nur sie zeigen, ob eine KI die Marke von sich aus empfiehlt. Steht der Name in der Frage, spricht die Antwort fast zwangsläufig über diese Marke und blendet die Wettbewerber aus. Sotiq zeigt bei solchen Prompts auch, welche anderen Marken an ihrer Stelle genannt werden.
Nach dem ersten Report sollte ein Team mit den Maßnahmen beginnen, die ohne Änderung an der eigenen Website auskommen: Erwähnungen in Quellen, die die KI schon zitiert, und Korrekturen falscher Angaben in fremden Quellen. Ein Redesign ist so gut wie nie der richtige erste Schritt. In Sotiq zeigt die Quellen-Analyse, welche zitierten Seiten die Marke noch nicht nennen, und Sam schlägt daraus einen Plan vor, den das Team freigibt.
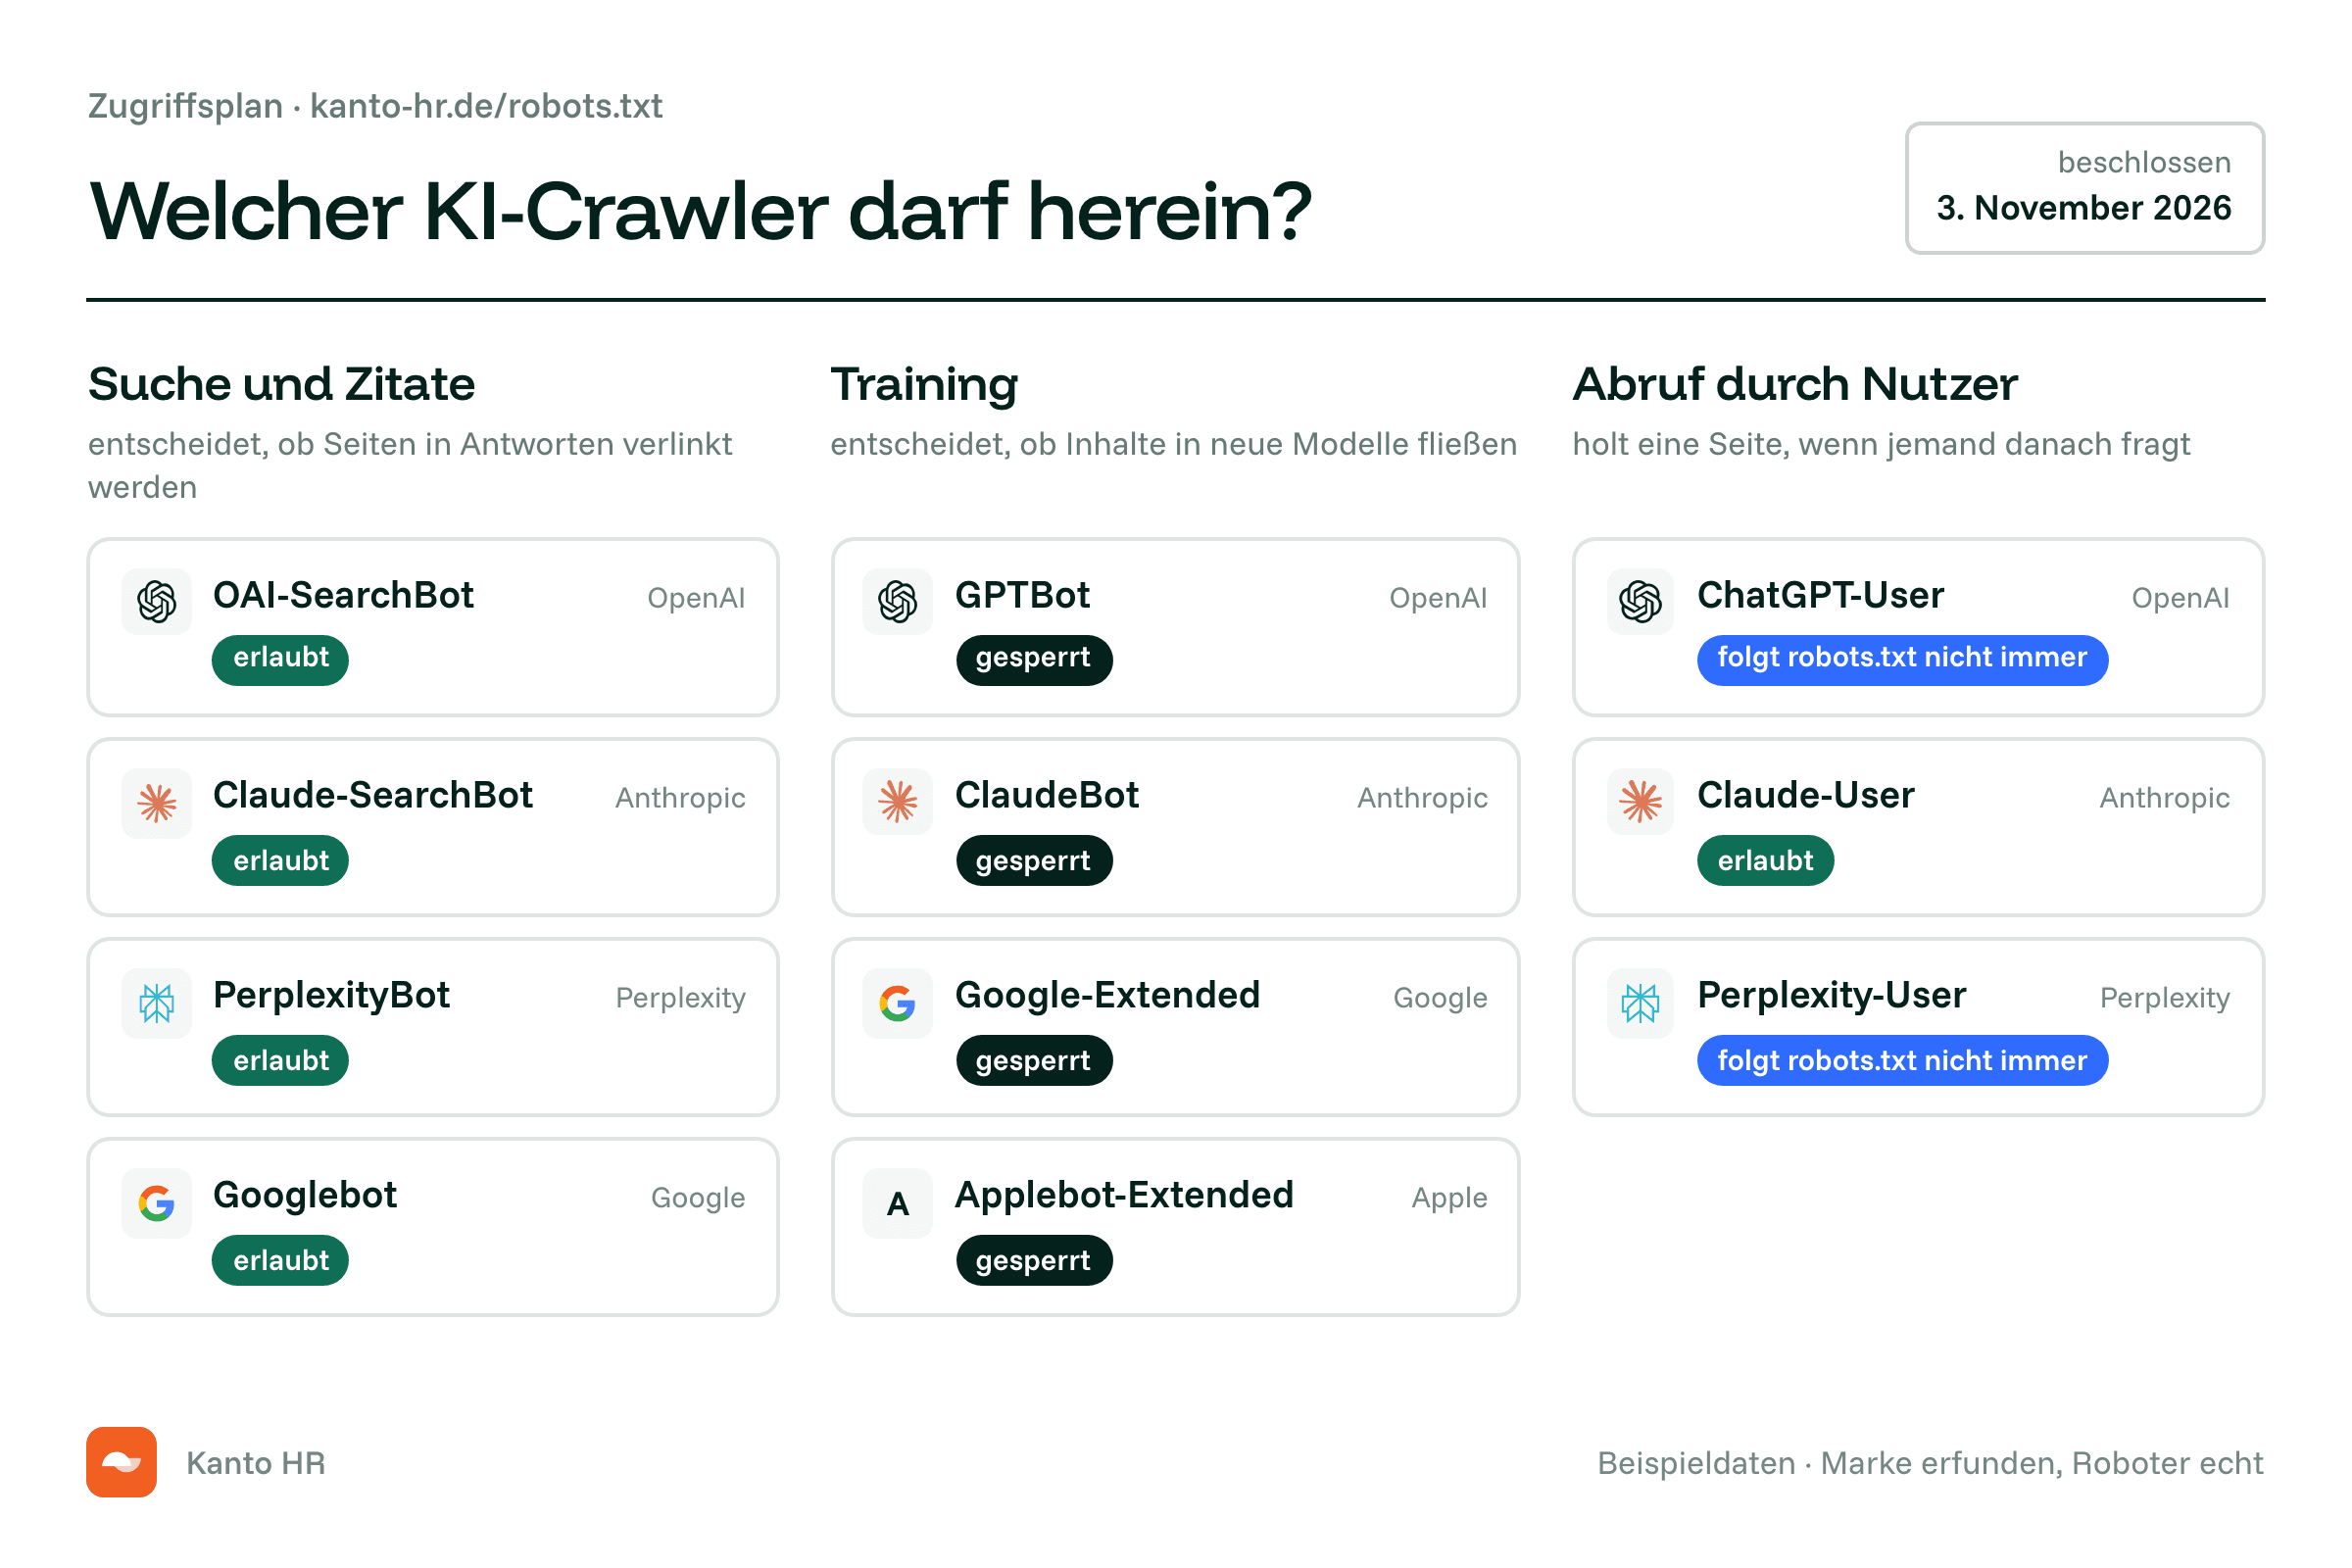
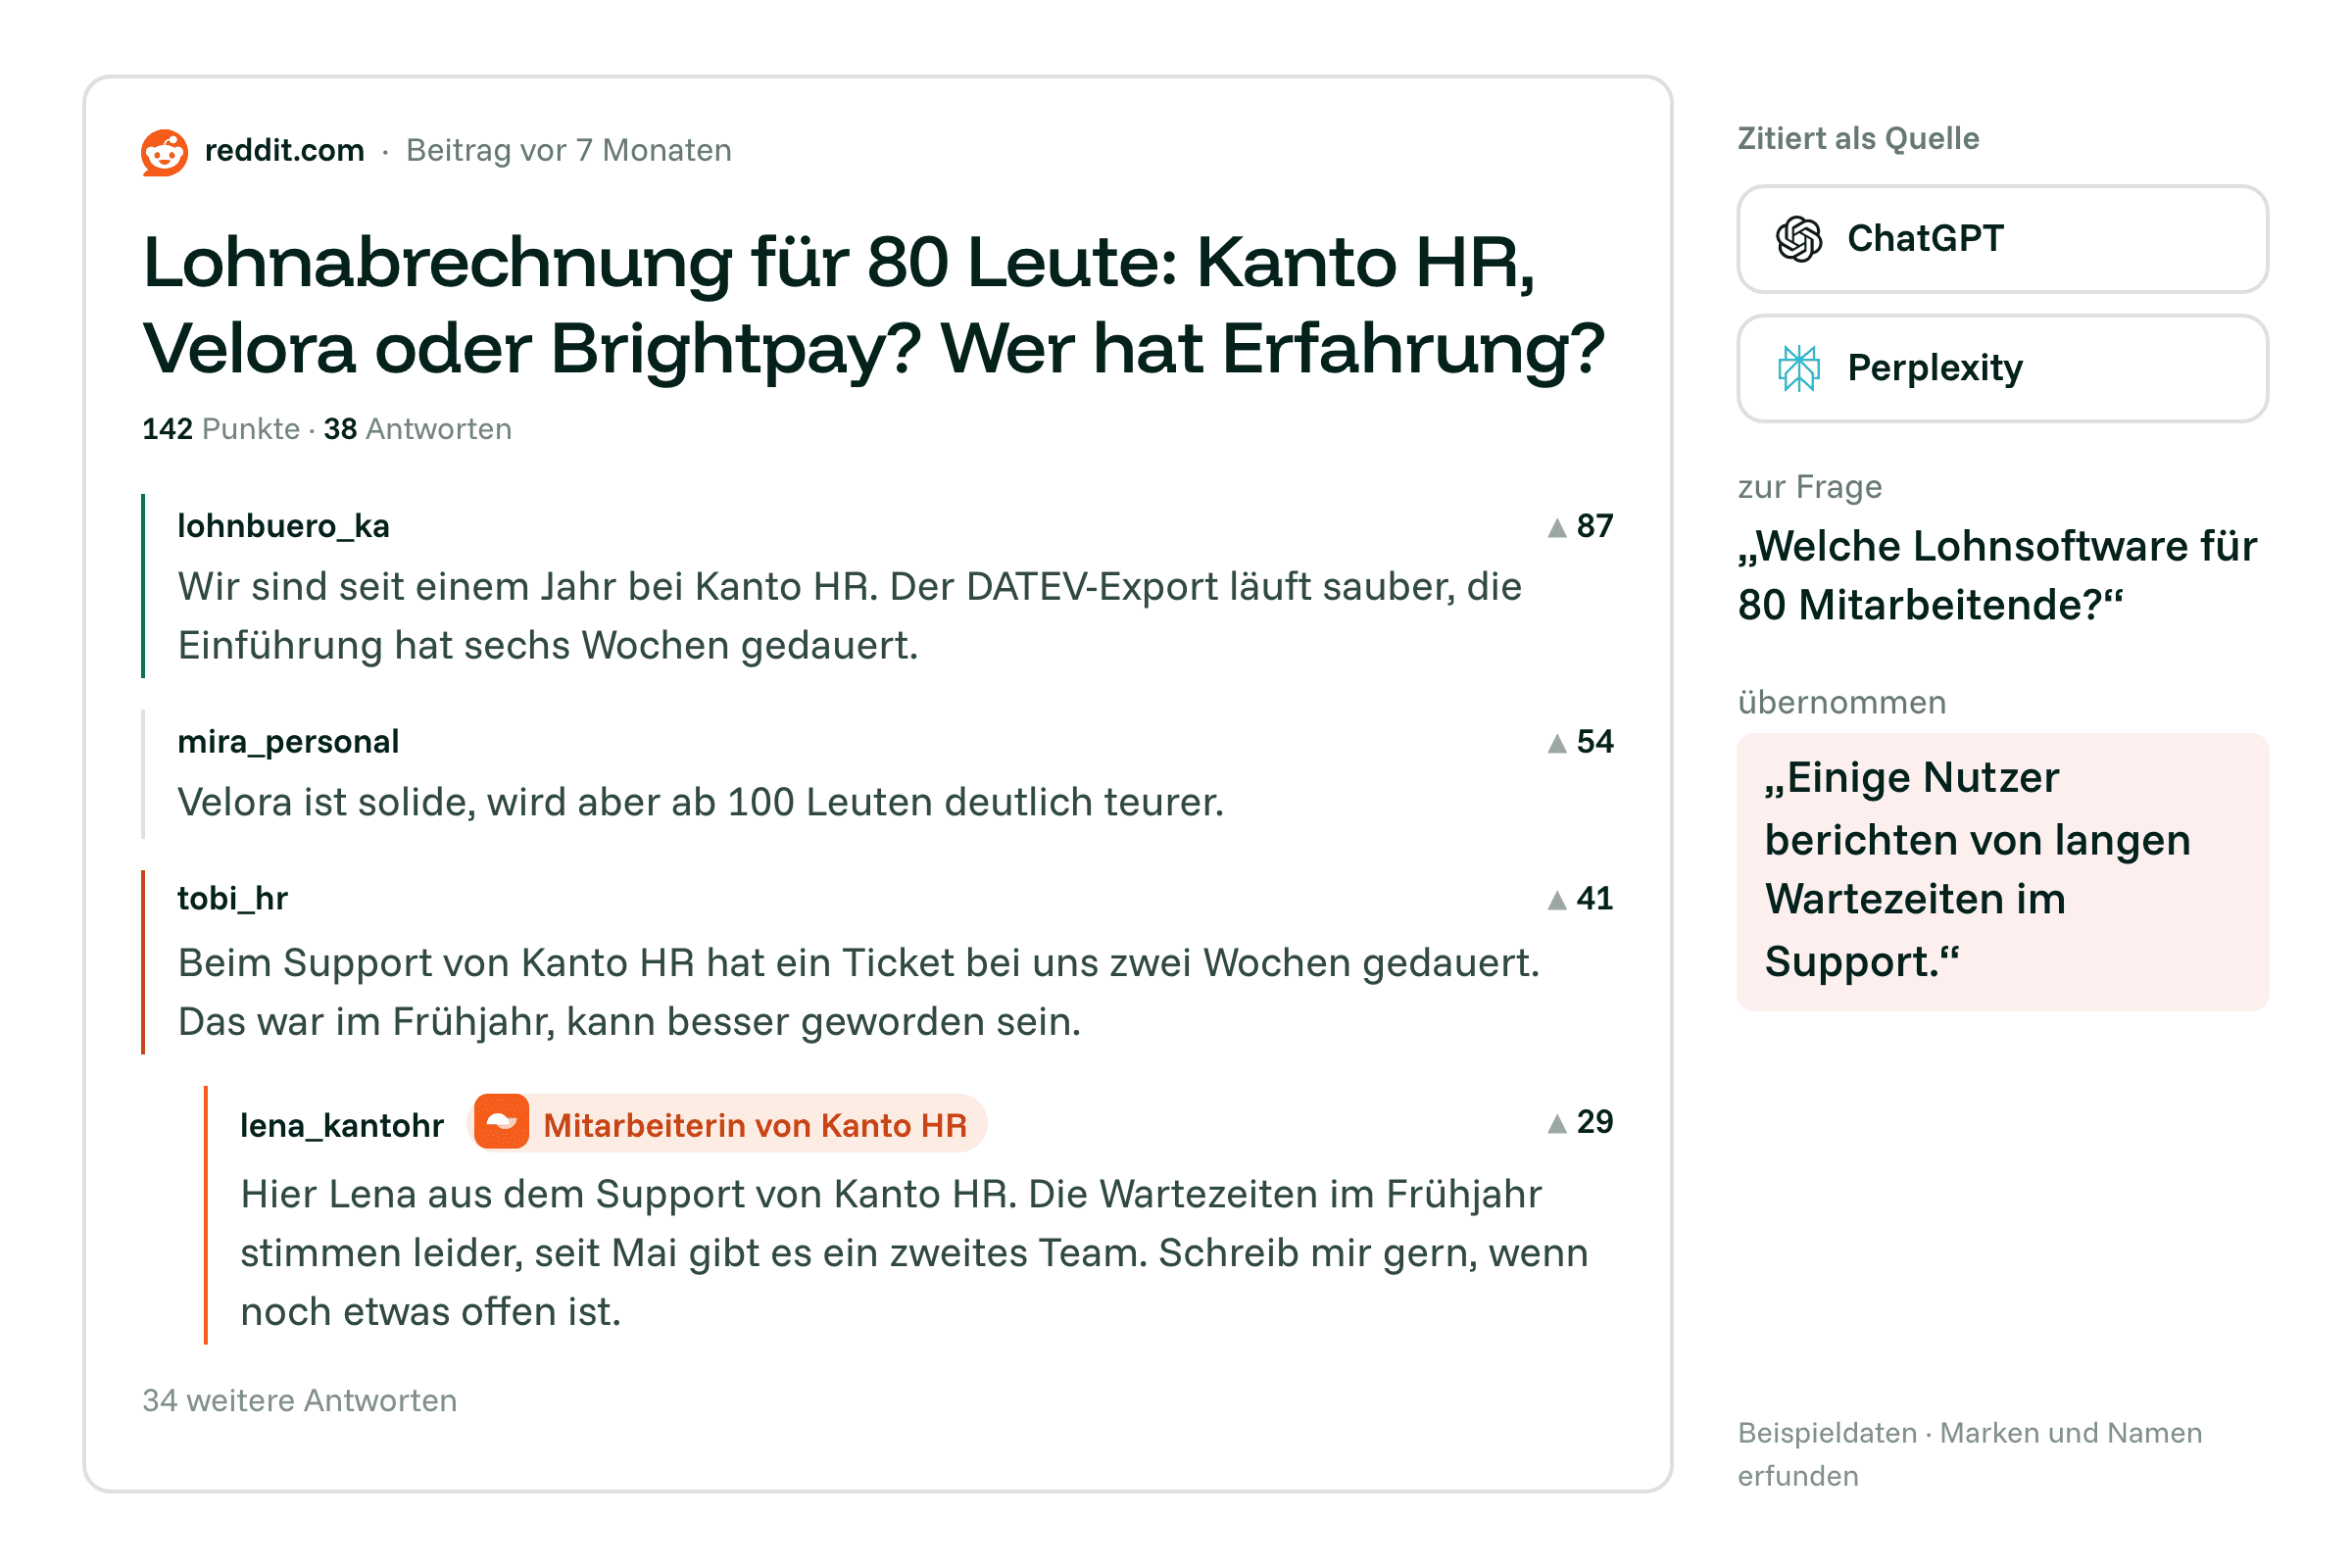
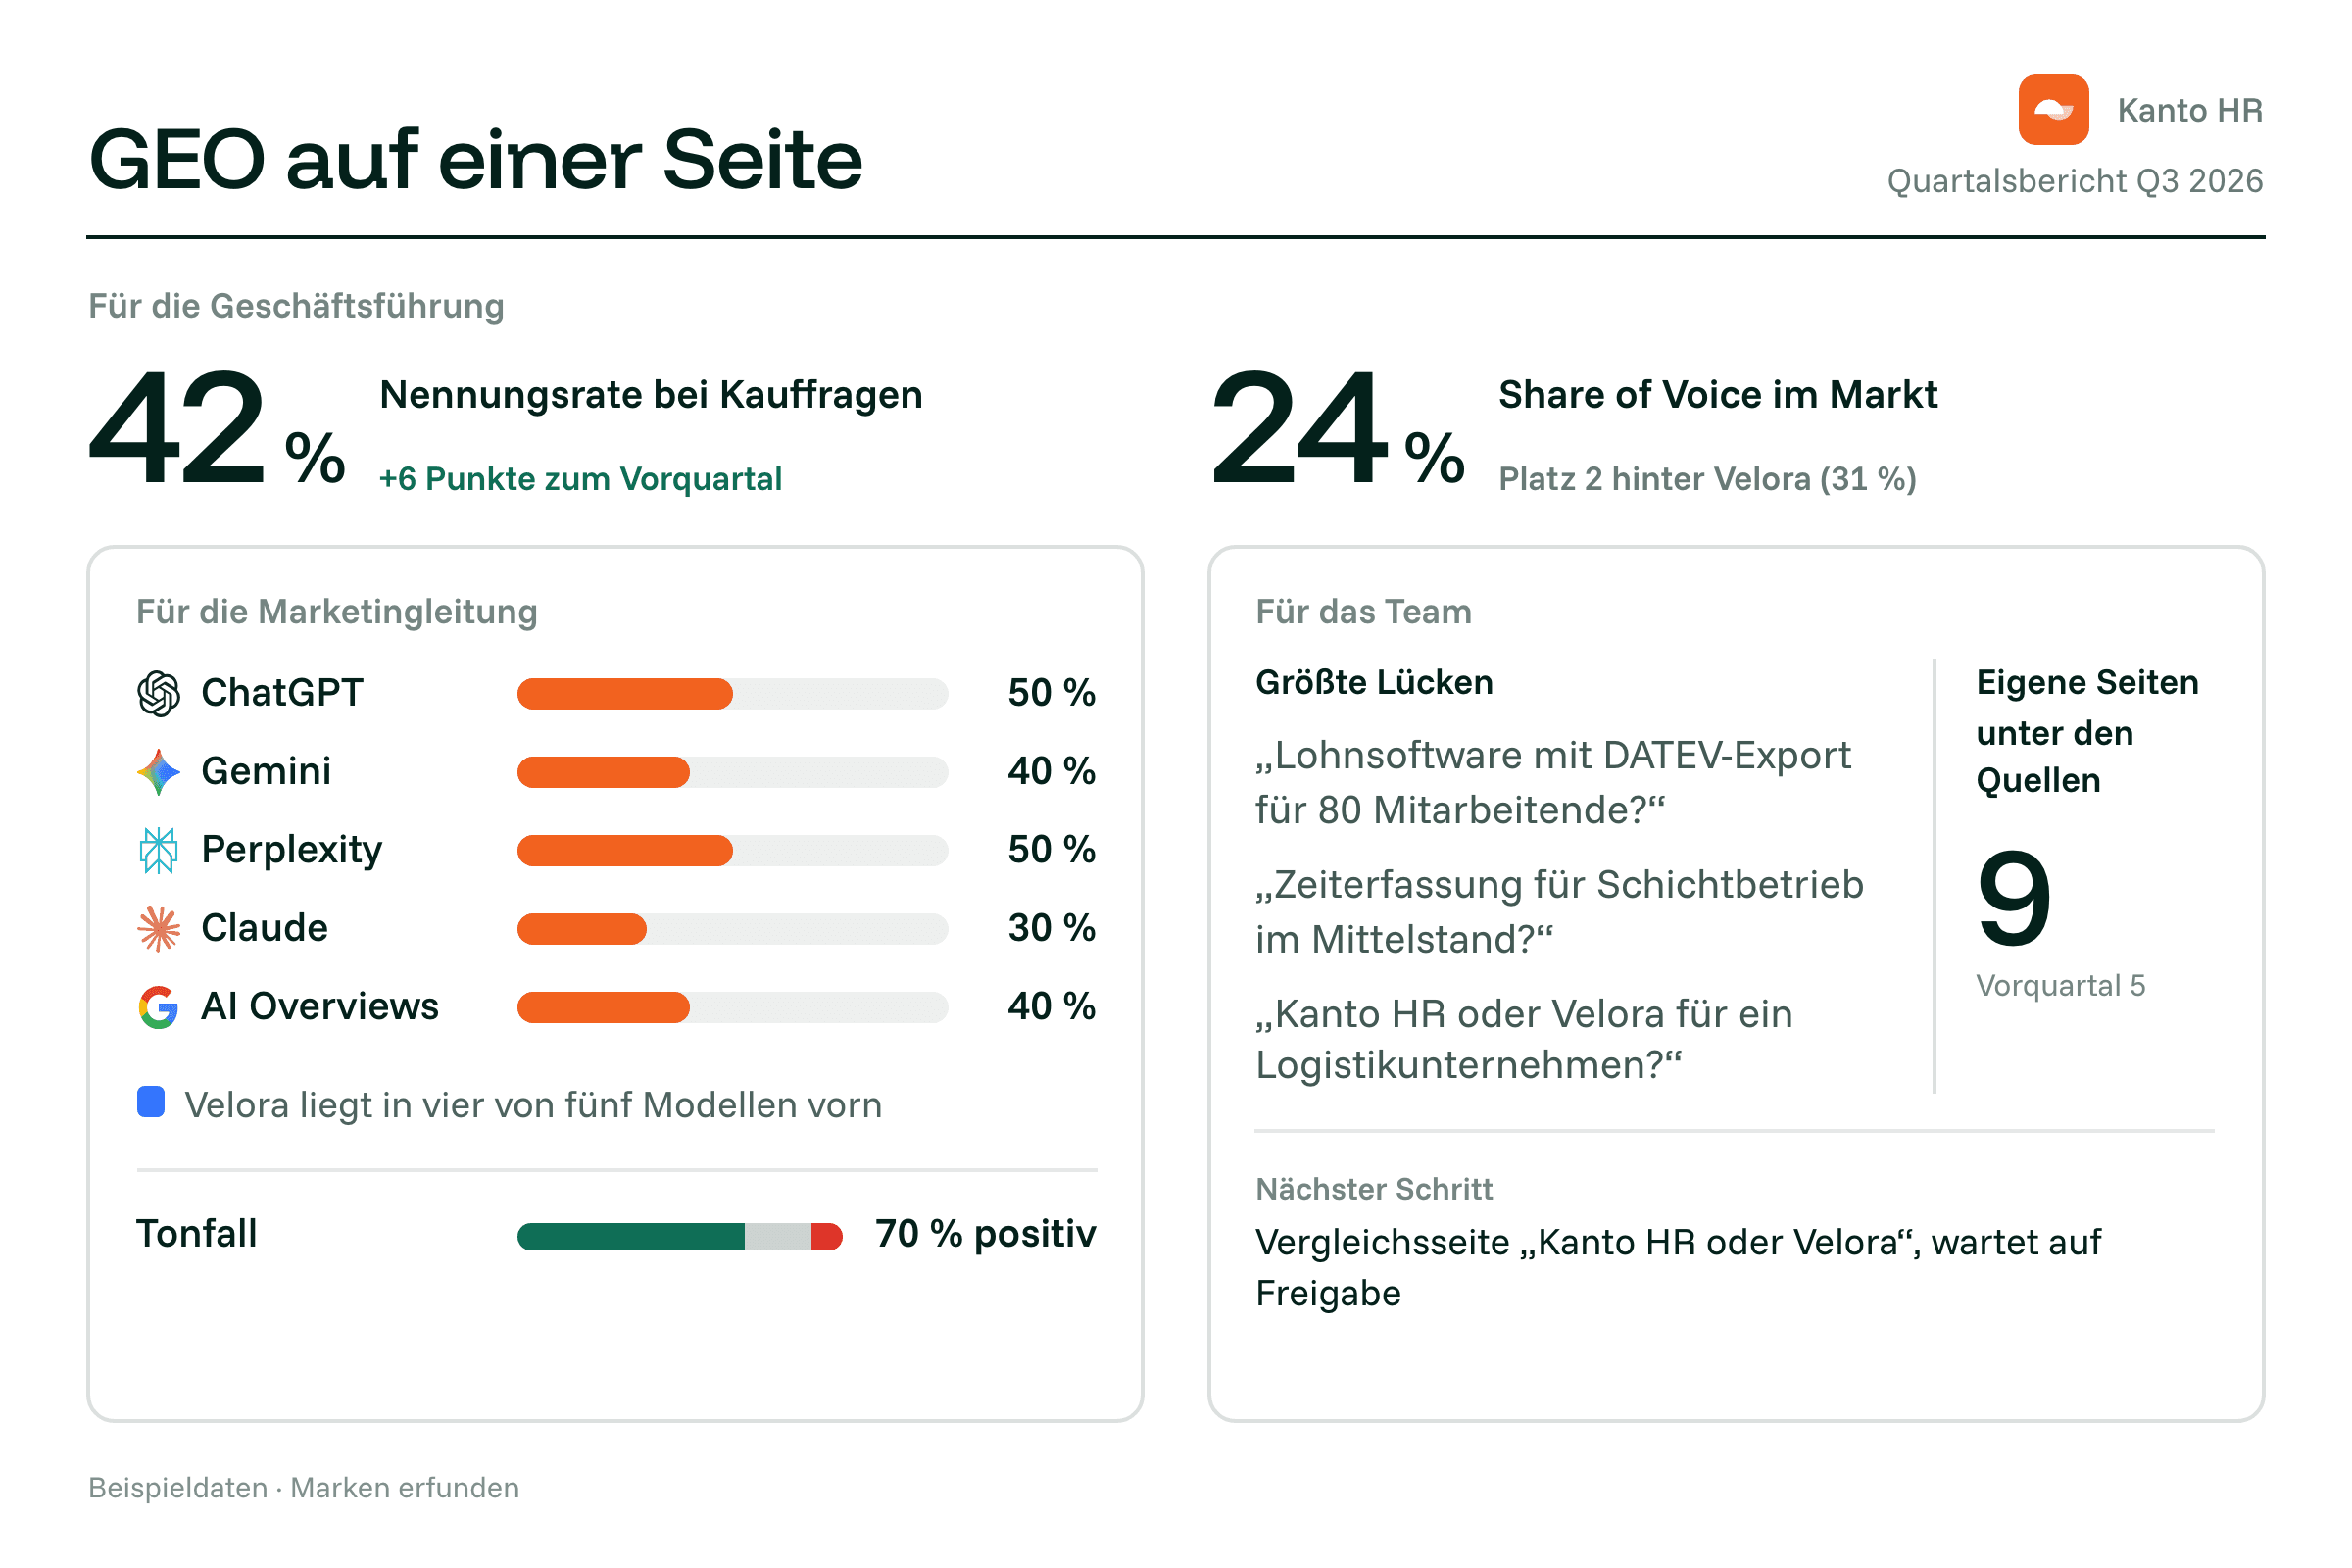
Messen mit Sotiq.
Getaggte Prompts, Quellen je Thema und der Ton der Antworten an einem Ort.
 omr.de18 Zitate
 reddit.com12 Zitate
 wikipedia.org7 Zitate
Sam übernimmt das.
Sam legt mit Ihnen ein getaggtes Prompt-Set an, misst es jeden Tag und sagt Ihnen nach dem ersten Report, womit Sie anfangen sollten.


