Blog
KI-Suche 2026: Was wirklich funktioniert,was 2025 nur Hype war
2025 war das erste Jahr, in dem KI-Sichtbarkeit in vielen Teams ein eigenes Budget hatte. Zeit für eine Bilanz: Was hat in ChatGPT, Gemini und Perplexity messbar gewirkt, was war am Ende nur Hype, und worauf solltest du 2026 setzen?

Kaum ein Marketingteam ist 2025 ohne den Satz „Wir müssen mal schauen, was ChatGPT über uns sagt“ durch das Jahr gekommen. Aus der Frage wurden Tools, Budgets und Stellenprofile. Dazu kam eine Abkürzungslandschaft, die sich zwischen AEO, GEO, LLMO und AIO nicht einmal auf einen Namen einigen konnte. Nach zwölf Monaten liegen genug Erfahrungswerte vor, um zwei Dinge sauber zu trennen: was tatsächlich Wirkung gezeigt hat und was vor allem gut klang.
Die Bilanz fällt unbequem aus. Einige der am lautesten beworbenen Techniken haben wenig geliefert. Gleichzeitig haben ausgerechnet die Taktiken funktioniert, die kein Team gerne in ein Whitepaper schreibt. Und die Aussicht, dass sich das schnell wieder verwächst, ist gering.
Ich gehe hier sieben Fragen durch: vom Rückblick auf den Hype über die Mechanismen, die überraschend gut liefen, bis zu den Zahlen, die B2B-Teams heute tatsächlich in ihren Dashboards sehen.
Das Wichtigste in Kürze
KI-Suche ist 2026 keine eigene Disziplin neben SEO, sondern deren Fortsetzung mit anderen Signalen. Gewirkt haben 2025 nicht technische Dateien wie llms.txt oder zusätzliche strukturierte Daten, sondern Erwähnungen: Listicles, bezahlte Platzierungen auf Review-Seiten, gegenseitige Nennungen zwischen Marken und Inhalte auf UGC-Plattformen. Wer 2026 belastbar sichtbar sein will, produziert eigene Daten statt Rewrites, versteht die Messung der KI-Sichtbarkeit als Brand Monitoring statt als Keyword-Tracking und rechnet in Conversions statt in Sichtbarkeitspunkten. Im B2B-SaaS liegen die berichteten Anteile aus KI-Such-Traffic bei 10 bis 20 Prozent, im B2C dagegen meist unter einem Prozent.
Was war 2025 in der KI-Suche überhyped?
Die ehrlichste Antwort betrifft die Kategorie selbst. Ihre aktuelle Größe war überhyped. Das heißt nicht, dass KI-Suche unwichtig wäre. Es heißt, dass die Lautstärke der Debatte 2025 deutlich über dem lag, was das Feld an tatsächlichem Volumen, Budget und Umsatz hergegeben hat. Wer den Markt anhand von Konferenzagenden und LinkedIn-Feeds eingeschätzt hat, hat ihn systematisch zu groß gerechnet.
Sind AEO und GEO wirklich eine eigene Disziplin?
Der zweite überbewertete Punkt ist die Behauptung, SEO und AEO seien komplett verschiedene Disziplinen. Die These war gutes Marketing für neue Tools und neue Beratungsangebote. Der Praxis hielt sie nicht stand. Was eine Seite in KI-Antworten zitierfähig macht, überschneidet sich sehr weitgehend mit dem, was sie auch in klassischen Trefferlisten trägt: eine Seite, die erreichbar ist, eine Frage, die sie klar beantwortet, und eine Marke, über die anderswo geschrieben wird.
Teams, die 2025 eine zweite Organisation neben ihrem SEO aufgebaut haben, haben vor allem Overhead produziert. Falls du gerade überlegst, ob du eine eigene GEO-Einheit brauchst: Ich halte das in den allermeisten Fällen für die falsche Frage. Die bessere lautet, ob dein bestehendes SEO-Team zwei Tage im Monat freigeschaufelt bekommt, um sich mit Antwortmaschinen zu beschäftigen. Wer die Zeit nicht freiräumt, löst das Problem auch nicht mit einem neuen Kästchen im Orgchart.
Welche technischen Hacks haben 2025 nicht geliefert?
Am deutlichsten fällt das Urteil über die technischen Abkürzungen aus, mit denen 2025 gehandelt wurde:
- llms.txt als Wachstums-Hack. Die Datei wird deutlich überschätzt. Nützlich ist sie dort, wo maschinelle Konsumenten ohnehin gezielt Dokumentation abrufen, also bei APIs und Coding Agents. Als Sichtbarkeitshebel für eine Marke ist sie nicht belegt. Und weil jeder sie selbst schreibt, ist sie anfällig für Spam.
- Strukturierte Daten speziell für AEO und GEO. Markup bleibt sinnvoll und gehört zur Hausarbeit jeder Website. Es als Wundermittel für KI-Sichtbarkeit zu verkaufen, war 2025 eines der überzogensten Versprechen der Kategorie.
- Markdown-Kopien jedes Artikels. Von jedem Beitrag eine zusätzliche Markdown-Fassung auszuliefern, war 2025 eine beliebte Empfehlung. Als eigenständige Strategie hat sie sich nicht bewährt.
Alle drei Ansätze haben denselben blinden Fleck: Sie sind Arbeit an der Auslieferung, nicht am Inhalt. Sie ändern, wie eine Seite bereitsteht, nicht, ob sie etwas zu sagen hat. Ein Modell, das deine Seite bereits problemlos lesen kann, liest sie durch eine zweite Fassung nicht besser. Es zitiert sie nur dann, wenn dort etwas steht, das es sonst nirgends findet.
Meine Einschätzung nach einem Jahr: Solche Dateien kann man mitnehmen, solange sie in einer Stunde erledigt sind. Sobald jemand ein Projekt daraus macht, ist die Stunde falsch investiert. Wo tatsächlich Substanz fehlt, bringt dich die strukturelle Optimierung bestehender Seiten weiter als eine zusätzliche Datei im Wurzelverzeichnis.
Was hat 2025 in der KI-Suche überraschend gut funktioniert?
Die Liste dessen, was gewirkt hat, liest sich wie das Gegenteil einer Best-Practice-Sammlung. Sprachmodelle haben 2025 nicht die saubersten Seiten aufgegriffen. Sie haben die Aussagen aufgegriffen, die am häufigsten und am eindeutigsten formuliert waren, ziemlich unabhängig davon, wer sie aufgestellt hat.
Warum funktionieren selbstbezogene Listicles so gut?
Der schlichteste Fall ist das selbstbezogene Listicle: ein Beitrag auf der eigenen Domain mit dem Tenor „Die besten Anbieter in Kategorie X“, und die eigene Marke steht auf Platz eins. Was in der klassischen Suche seit Jahren als plumpe Eigenwerbung gilt, funktioniert weiterhin, in Google genauso wie in ChatGPT, Gemini und Perplexity.
Der Grund liegt im Format, nicht im Wahrheitsgehalt. Ein Modell, das eine Liste von Anbietern zusammenstellen soll, findet in einem Listicle exakt die Struktur, die es ausgeben will: benannte Kandidaten, eine Reihenfolge, ein Satz Begründung je Position. Es muss die Information nicht mehr aus Fließtext rekonstruieren, sondern kann sie übernehmen. Genau diese Bequemlichkeit belohnt es.
Was sind gekaufte Platzierungen und reziproke Erwähnungen?
Eine Stufe darüber liegen Affiliate- und Review-Seiten, die gegen Bezahlung Marken als Testsieger listen. Aus Sicht des Modells ist das eine externe, redaktionell wirkende Quelle. Dass die Reihenfolge kommerziell zustande kam, ist im Text nicht erkennbar und im Modell-Output erst recht nicht. In dieselbe Richtung geht eine Beobachtung, die in der Branche offen als „über sich selbst lügen“ bezeichnet wird: Marken behaupten auf der eigenen Website, sie seien auf einem großen Bewertungsportal die Nummer eins oder würden von einem bekannten Wirtschaftsmagazin empfohlen. Sprachmodelle übernehmen solche Behauptungen, besonders bei kleineren Marken, über die es sonst wenig zu lesen gibt.
Der interessanteste Mechanismus ist der dritte: reziproke Erwähnungen. Zwei Marken nennen sich gegenseitig, jeweils in einem sinnvollen Integrations-Kontext. Ein Tool für Meeting-Transkripte beschreibt, wie es sich in eine Videokonferenz-Software einklinkt, und die Videokonferenz-Software führt es im eigenen Integrationsverzeichnis. Beide Seiten haben einen echten Anlass für die Erwähnung, keine der Nennungen wirkt gekauft, und für ein Sprachmodell entsteht daraus ein Beleg, dass die beiden Produkte zusammengehören.
Faktisch ist das der Linkaufbau der KI-Suche, nur ohne Link. Was zählt, ist die Nennung im richtigen Zusammenhang, nicht das href. Und anders als beim klassischen Linktausch fällt hier kaum ein Muster auf, weil beide Erwähnungen für sich genommen völlig plausibel sind.
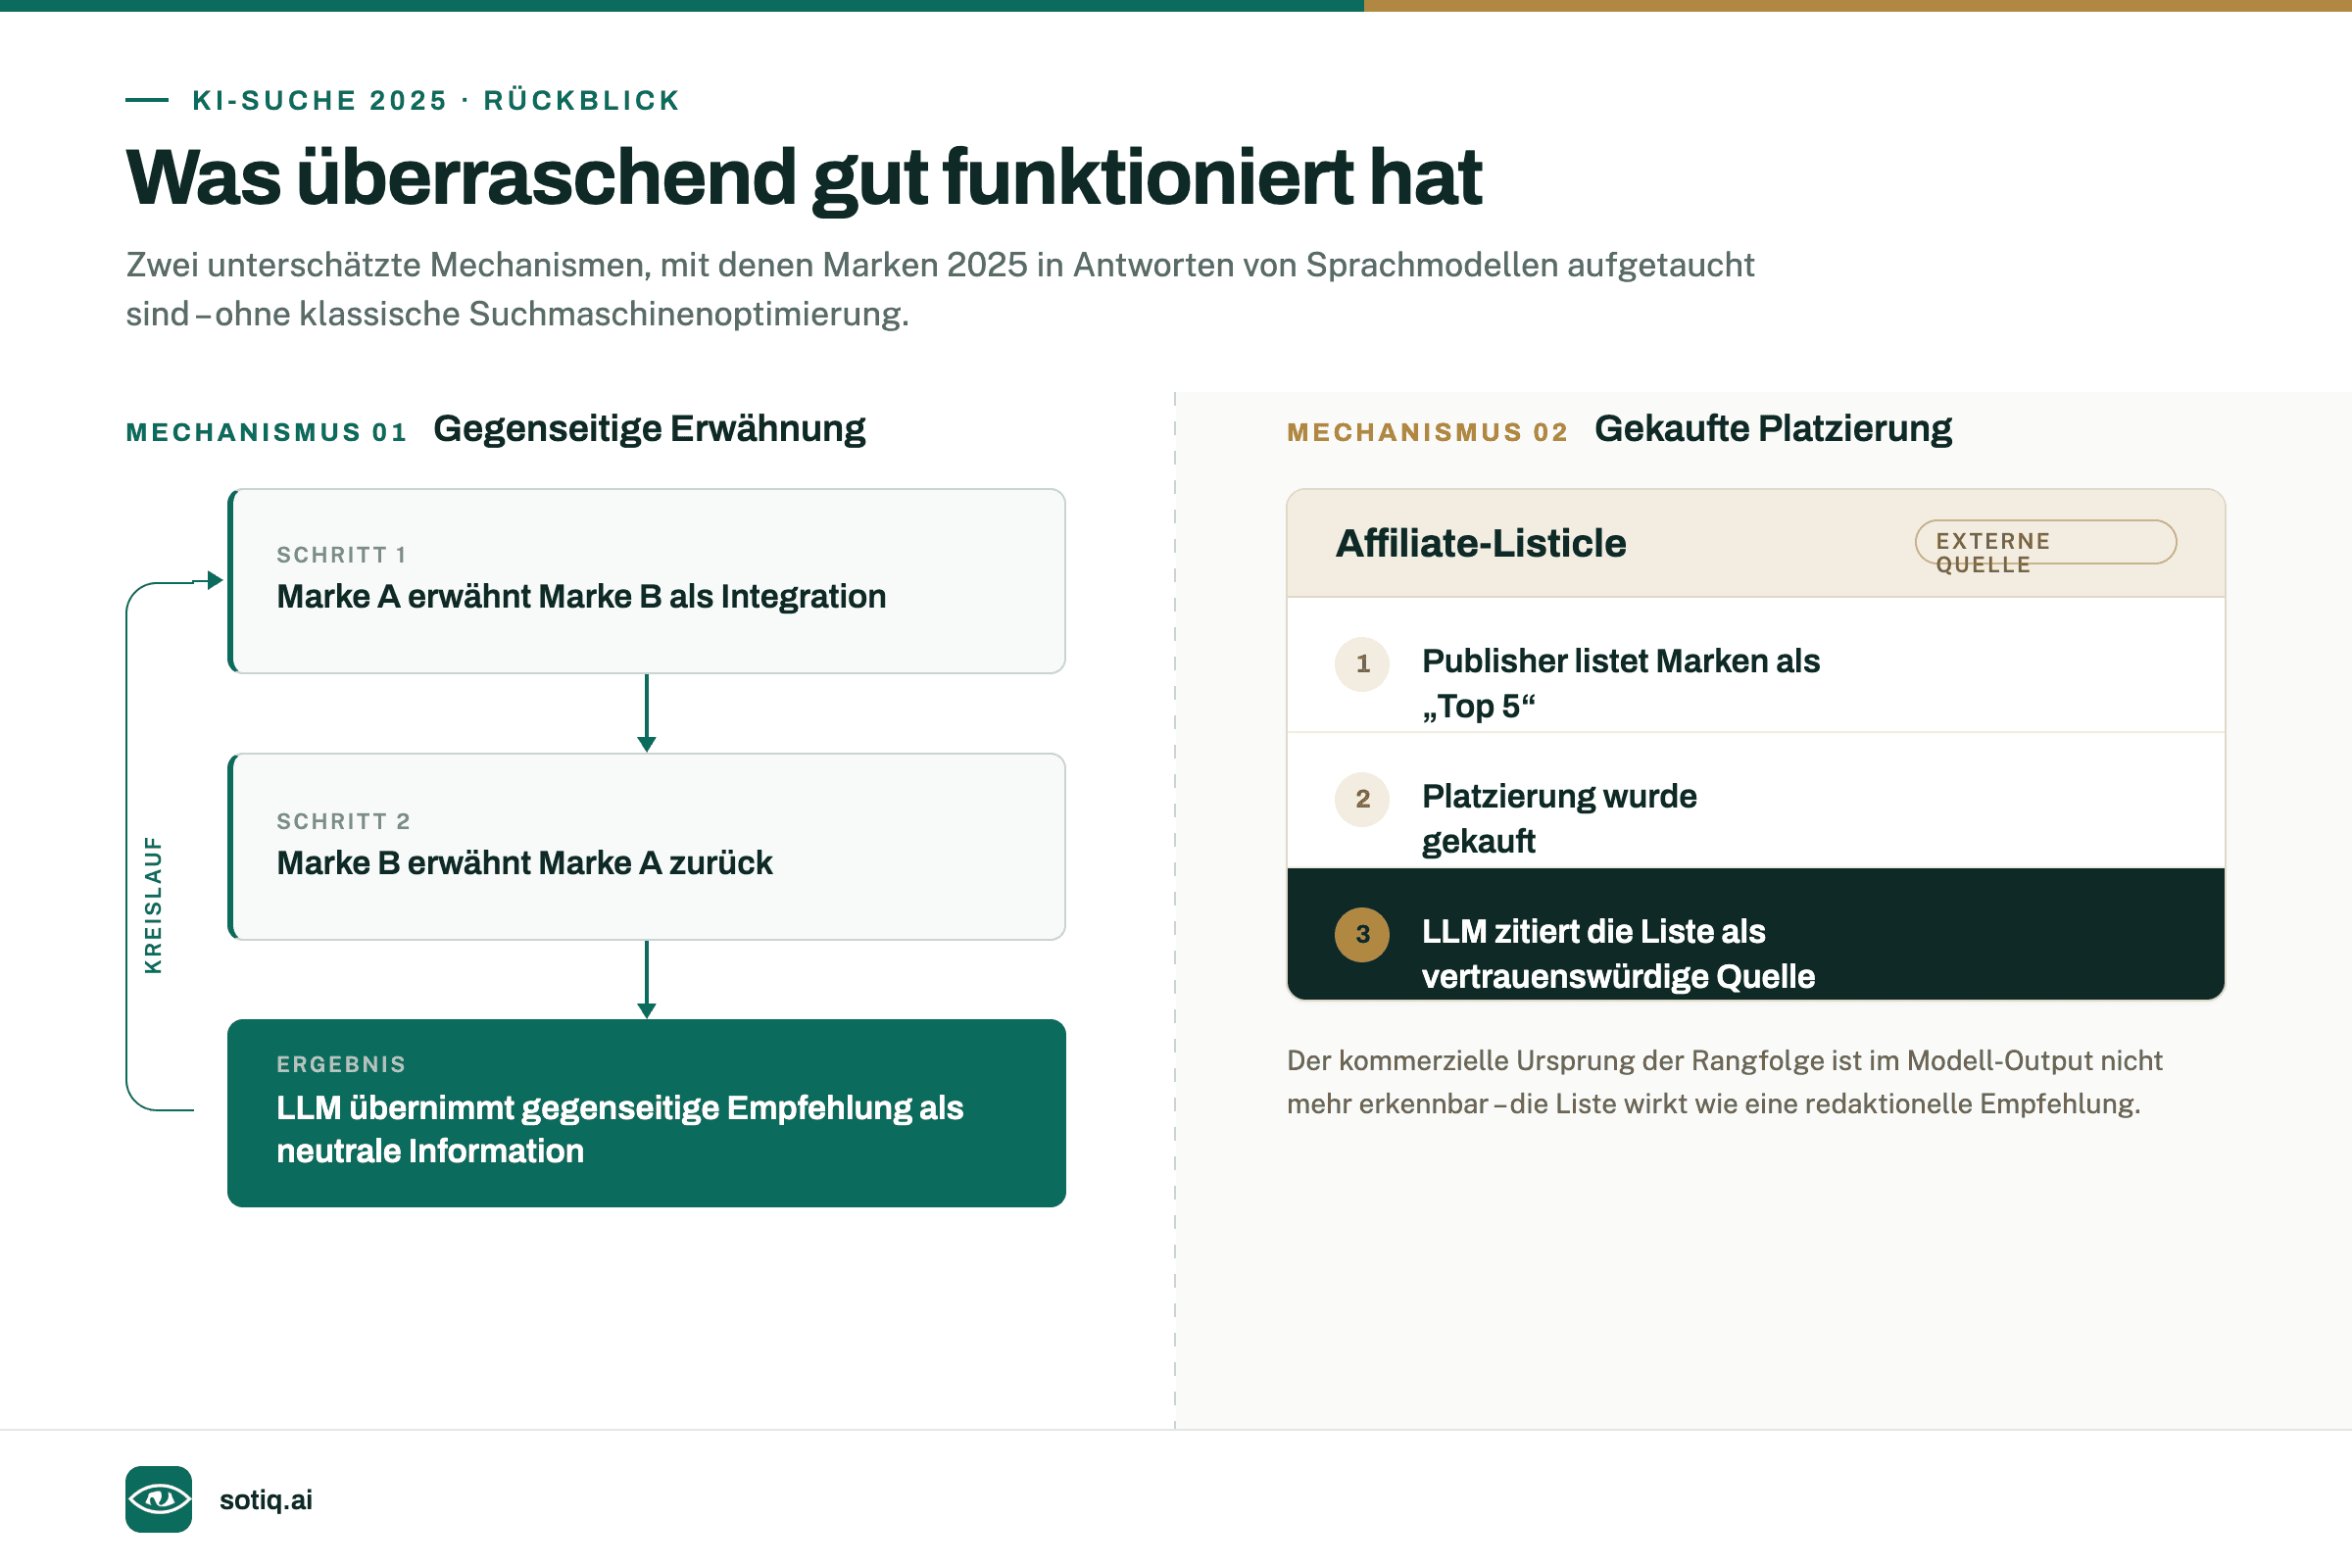
Zwei Mechanismen, mit denen Marken 2025 in KI-Antworten aufgetaucht sind: gegenseitige Erwähnungen und gekaufte Listicle-Platzierungen. In beiden Fällen ist im Modell-Output nicht mehr erkennbar, wie die Empfehlung zustande kam.
Wie lange funktionieren diese Taktiken noch?
Nicht alles davon ist stabil. Das gezielte Platzieren von Markennennungen in Reddit-Threads funktioniert aktuell, wird aber nach verbreiteter Einschätzung nicht dauerhaft halten. Dafür ist der Druck auf die Plattform zu groß und der Missbrauch zu offensichtlich.
Für den Rest fällt die Prognose nüchtern aus: Vieles davon wird noch lange funktionieren. Die Begründung ist ein Blick zurück statt nach vorn. Affiliate-Seiten und Listicles überleben in Google seit über zwanzig Jahren, obwohl jede Suchmaschinengeneration angetreten ist, sie einzudämmen. Es gibt wenig Grund anzunehmen, dass Sprachmodelle dieses Muster schneller aufbrechen als eine Suchmaschine mit zwei Jahrzehnten Erfahrung.
Ich würde trotzdem keinem Kunden empfehlen, sich in Testsieger-Listen einzukaufen. Nicht aus Prinzipienreiterei, sondern weil du damit eine Position mietest, die dir nicht gehört. Sie verschwindet in dem Monat, in dem ein Wettbewerber mehr zahlt oder der Publisher den Beitrag aktualisiert. Was bleibt, ist eine Sichtbarkeit ohne Substrat. Wer diese Taktiken nicht selbst fährt, sollte aber zumindest wissen, wenn Wettbewerber es tun. Ein laufendes Wettbewerber-Tracking in KI-Antworten zeigt genau diese Verschiebungen, bevor sie sich in Verkaufszahlen niederschlagen.
Was sollten Marken und Teams 2026 mehr tun?
Dass etwas funktioniert, macht es noch nicht zur Strategie. Die Empfehlungen für 2026 gehen konsequent in die Gegenrichtung der Taktiken aus dem vorigen Abschnitt. Weg von dem, was ein Modell aufgreift, weil es formal passt. Hin zu dem, was es aufgreift, weil es sonst nirgends steht.
Warum sind eigene Daten die nachhaltigere Strategie?
Originale Forschung, eigene Daten und echte Einbindung von nutzergenerierten Inhalten sind der Punkt, bei dem sich in der Branche fast alle einig sind. Der Grund ist strukturell. Ein Sprachmodell kann eine Aussage nur aus einer Quelle nehmen, wenn sie in dieser Quelle steht. Bei einer Zahl, die nur ein Anbieter erhoben hat, gibt es genau eine Adresse. Bei einer Einschätzung, die in vierzig Blogbeiträgen ähnlich formuliert ist, gibt es vierzig, und die Wahrscheinlichkeit, dass deine darunter ist, sinkt entsprechend.
Daraus folgt die zweite Regel: Content muss netto neue Informationen liefern und darf kein Rewrite bestehender Artikel sein. Das ist weniger eine Qualitätsfrage als eine Mengenfrage. Ein umgeschriebener Beitrag erhöht die Zahl der Quellen für eine bereits belegte Aussage, ohne eine neue hinzuzufügen. Er konkurriert also mit dem Bestand, statt Terrain zu gewinnen. Wenn aus vorhandenen Daten ein zitierfähiger Beitrag werden soll, hilft dir ein Artikelaufbau, der auf konkrete Fragen antwortet, mehr als eine weitere Runde Textoptimierung.
Ist Prompt-Tracking eher Brand Monitoring oder Keyword-Tracking?
Für die tägliche Arbeit ist das der folgenreichste Punkt des ganzen Jahres. Prompt-Tracking sollte eher wie Brand Monitoring oder Word-of-Mouth verstanden werden als wie Keyword-Tracking. Der Unterschied klingt akademisch, verändert aber das komplette Reporting.
Keyword-Tracking fragt nach einer Position auf einer Skala und erwartet Bewegung nach oben. Brand Monitoring fragt, in welchem Zusammenhang über eine Marke gesprochen wird, wer sonst genannt wird und in welcher Tonlage. Es akzeptiert, dass es darauf keine einzelne Zahl gibt. Eine Nennungsrate über eine Prompt-Menge und über ChatGPT, Gemini und Perplexity hinweg ist deshalb ein Trendwert, keine Rangposition. Wer sie wie ein Ranking liest, optimiert auf Rauschen und erklärt im Monatsreport Schwankungen, die keine Ursache haben.
Wer sie dagegen als Erwähnungsquote liest, sieht dieselben Daten als das, was sie sind: ein Bild davon, wie präsent eine Marke im Gespräch ist. Genau darauf ist Prompt-Tracking als Messverfahren ausgelegt, und die Tonlage der Antworten gehört in dieser Lesart genauso in den Bericht wie die Häufigkeit.
Was macht eine belastbare Case Study aus?
Der dritte Wunsch für 2026 ist methodischer Natur: mehr saubere Case Studies. Sauber heißt vier Dinge. Klare Metriken, die vor dem Test feststehen. Eine Kontrollgruppe, damit man weiß, was ohne die Maßnahme passiert wäre. Zugang zu den Rohdaten. Und eine Beschreibung, die ausreicht, um den Versuch nachzustellen.
Der Kontrast zum Bestand ist ernüchternd. Der Großteil dessen, was 2025 als Beleg durch die Fachöffentlichkeit lief, waren Screenshots einzelner Antworten. Ohne Vergleichsfall, ohne Zeitreihe, ohne die Möglichkeit, das Experiment zu wiederholen. Für eine Kategorie, die um Budgets konkurriert, ist das auf Dauer zu wenig. Es ist auch der Grund, warum die Debatte so laut und so beliebig war: Wenn niemand widerlegen kann, kann jeder behaupten.
Wer sind die Gewinner und Verlierer der KI-Suche?
Wer von der Verschiebung profitiert, entscheidet sich weniger über Branchen als über Formate. Es gewinnt, wer Inhalte hat, die ein Modell schlecht selbst erzeugen kann.
Welche Plattformen gewinnen an Gewicht?
- Video-Plattformen, allen voran YouTube. Potenziell der größte Profiteur, allerdings mit einer Bedingung: sobald Sprachmodelle Videoinhalte besser erschließen. Der Bestand ist riesig, weitgehend unerschlossen und liegt bei einem einzigen Anbieter.
- UGC-Seiten wie Reddit, Quora und Foren. Klare Gewinner, weil sie genau das enthalten, was in Marketingtexten fehlt: Erfahrungsberichte, Vergleiche und Kritik in der Sprache der Nutzer. Der Preis dafür ist ein wachsendes Spam-Problem, das mit der Bedeutung der Plattformen zunimmt.
Warum sind Affiliate- und Review-Seiten ein Paradox?
Affiliate- und Review-Seiten stehen in einer eigentümlichen Lage. Sie verlieren Traffic an AI Overviews, weil ihre Vergleichstabellen direkt in der Antwort zusammengefasst werden und der Klick ausbleibt. Gleichzeitig liefern sie exakt die Inhalte, die Sprachmodelle zitieren: bewertete Ranglisten und Gegenüberstellungen mehrerer Anbieter.
Ihr Geschäftsmodell erodiert also, während ihre inhaltliche Bedeutung steigt. Wie dieser Widerspruch aufgelöst wird, ist eine der offenen Fragen für 2026. Falls diese Seiten unrentabel werden und verschwinden, verlieren die Modelle einen erheblichen Teil ihrer Vergleichsbasis. Wovon sie dann zehren, hat bisher niemand überzeugend beantwortet.
Wer verliert?
Die klarsten Verlierer sind die klassischen „Sea of Sameness“-Content-Seiten: Ratgeberstrecken ohne eigene Daten und ohne erkennbare Meinung, die dasselbe sagen wie dreißig andere Seiten zum selben Stichwort. In der klassischen Suche konnten sie über Autorität und Aktualität trotzdem ranken. In einer Antwort, die eine Aussage aus mehreren Quellen synthetisiert, gibt es für die dreißigste identische Formulierung schlicht keinen Platz mehr.
Langfristig gewinnt, wer verifiziert menschlichen Content vorweisen kann. Je mehr maschinell erzeugter Text in den Index läuft, desto wertvoller wird ein belastbarer Nachweis, dass hinter einem Beitrag ein Mensch mit einer Erfahrung steht. Für Marken heißt das auch, die eigenen Spuren in externen Quellen zu kennen. Bewertungsportale, Foren und Fachmedien wiegen in dieser Rechnung schwerer als die eigene Domain.
KI-Suche und KPIs: Was wird gemessen, was zählt wirklich?
Beim Ziel gibt es keinen Dissens. Am Ende zählen Umsatz und Conversions, nicht Sichtbarkeitspunkte. Der Streit beginnt eine Ebene darunter, bei der Frage, wie man von der Erwähnung in einer KI-Antwort zu einer Zahl in der Umsatzrechnung kommt.
Warum ist Attribution in der KI-Suche so schwierig?
Das Problem liegt in der Mitte der Journey, und die bleibt opak. Der letzte Klick lässt sich messen, der erste Kontakt manchmal rekonstruieren. Was zwischen dem ersten „Welche Anbieter gibt es für X?“ und dem späteren direkten Aufruf der Domain passiert, ist in keinem Analytics-Tool sichtbar. Ein Nutzer, der eine Marke in einer ChatGPT-Antwort gesehen hat und zwei Tage später ihren Namen bei Google eingibt, erscheint als organischer Marken-Traffic. Die Wirkung ist real, die Zuordnung fehlt.
Deshalb gewinnt ein Instrument an Bedeutung, das in datengetriebenen Teams lange als weich galt: self-reported Attribution, also die schlichte Frage im Formular „Wie hast du von uns erfahren?“. Sie ist ungenau und verzerrt. Sie ist trotzdem häufig die einzige Quelle, die den Kanal überhaupt benennt. Wenn du 2026 eine Kennzahl neu einführst, dann diese. Ein Freitextfeld im Lead-Formular kostet dich eine halbe Stunde Entwicklungszeit und liefert nach einem Quartal mehr über den Kanal als jedes Attributionsmodell.
Welche Conversion-Anteile messen Teams heute?
Die Größenordnungen liegen weit auseinander, und genau das ist die eigentliche Nachricht. Für B2B und Tech werden Conversion-Anteile von 4 bis 10 Prozent aus KI-Such-Traffic berichtet. Aus einzelnen Kundenportfolios kommen Werte um 4 bis 5 Prozent, auch bei größeren, bekannten SaaS-Anbietern. Im B2B-SaaS tauchen einzelne Fälle mit 10 bis 20 Prozent auf. Im B2C liegt der Anteil rein klickbasiert dagegen meist unter einem Prozent. Die Spannweite reicht damit vom Rundungsfehler bis zum fünftwichtigsten Kanal, je nach Geschäftsmodell.
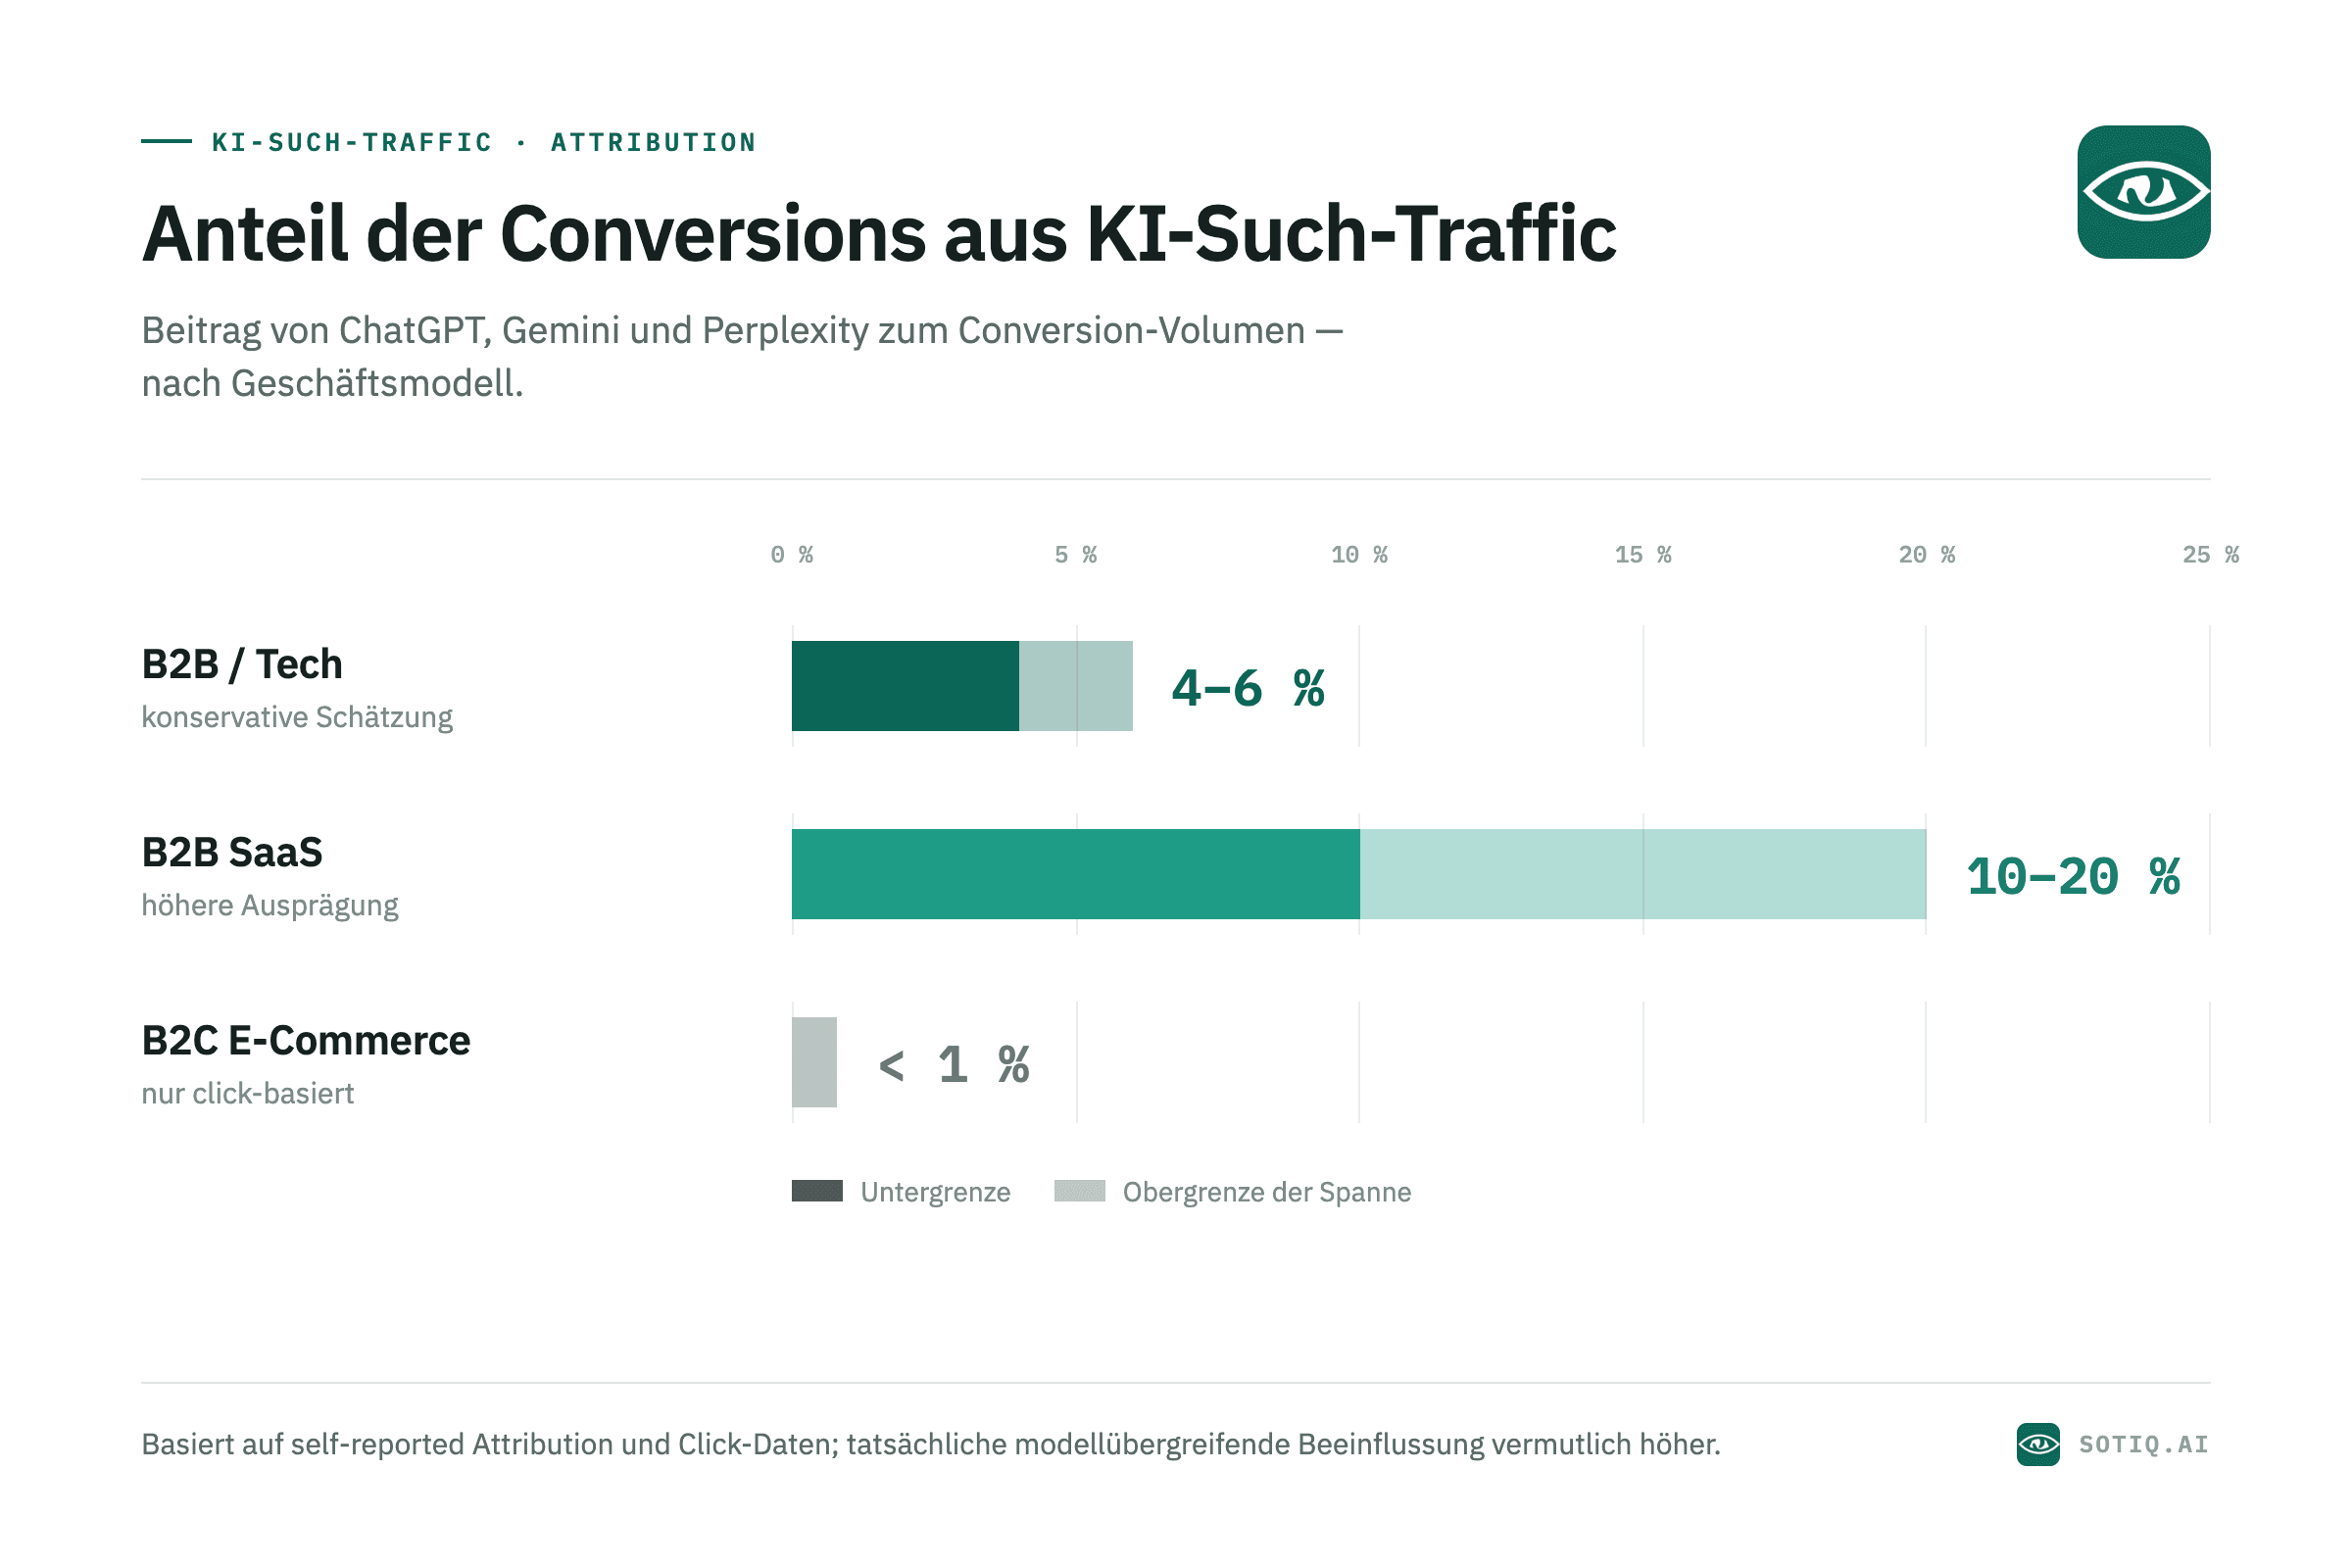
Anteil der Conversions aus KI-Such-Traffic nach Geschäftsmodell; für B2B/Tech ist das untere Ende der genannten Spanne abgetragen. Basis sind self-reported Attribution und Click-Daten, die tatsächliche Beeinflussung über den gesamten Entscheidungsweg liegt vermutlich höher.
Warum werden Sprachmodelle zum „Closer“ am Ende der Journey?
Der Abstand zwischen B2B und B2C erklärt sich über die Rolle, die Sprachmodelle im Entscheidungsprozess einnehmen. Sie werden zunehmend zum Entscheidungshelfer am Ende der Journey, also zum Closer. Nicht der Einstieg in ein Thema läuft über sie, sondern die letzte Absicherung vor der Entscheidung: „Was spricht gegen Anbieter A?“ oder „Passt B für ein Team von 40 Leuten?“. Dort, wo eine Kaufentscheidung erklärungsbedürftig ist und mehrere Kriterien abgewogen werden, ist der Beitrag am größten. Das ist in aller Regel B2B. Ein Paar Sneaker wird selten mit einem Sprachmodell abgewogen.
Für die Bewertung des Kanals folgt daraus etwas Unbequemes: Ein einstelliger Anteil am Traffic kann einen zweistelligen Anteil an den Abschlüssen tragen, weil dieser Traffic nicht am Anfang, sondern am Ende der Entscheidung steht. Wer KI-Sichtbarkeit nach Sitzungen bewertet, wird sie deshalb zuverlässig unterschätzen.
Wie entwickeln sich Plattformen und Oberflächen 2026?
Bei der Marktstruktur ist die Lage ungewöhnlich eindeutig. Google und OpenAI dominieren das Feld, alle anderen sind weit abgeschlagen. Als realistische Herausforderer gelten Apple, Meta und Microsoft. Nicht, weil ihre Produkte heute besser wären, sondern weil sie als Einzige über die Distribution verfügen, um eine Gewohnheit zu verschieben.
Warum wird Google Klicks im eigenen Ökosystem halten?
Das Argument dafür, dass Google Traffic künftig stärker im eigenen Ökosystem hält, ist bemerkenswert unspektakulär. Die KPIs der zuständigen Produktmanager sind nicht darauf ausgelegt, Traffic abzugeben. Wer intern daran gemessen wird, wie lange Nutzer in der eigenen Oberfläche bleiben, baut keine Funktion, die sie schneller hinausschickt.
Das ist keine Verschwörung, sondern eine Anreizstruktur. Und Anreizstrukturen verändern sich langsamer als jede Technologie. Wer seine Planung für 2026 darauf aufbaut, dass die Klickraten aus KI-Oberflächen wieder steigen, plant gegen die Zielvereinbarung der Leute, die diese Oberflächen bauen.
Was ändert sich an der Oberfläche?
Erwartet werden native Conversions und Checkouts direkt in ChatGPT, also der Abschluss innerhalb der Konversation statt der Weiterleitung auf eine Anbieterseite. Klassische Display-Werbung dürfte im Gegenzug an Bedeutung verlieren.
Für Marken ist das die unangenehmere Variante der Entwicklung. Wo der Kauf in der Oberfläche des Modells stattfindet, verschiebt sich nicht nur der Traffic, sondern auch die Kundenbeziehung. Du verlierst die Daten des ersten Kaufs, den Anlass für die erste E-Mail und die Kontrolle darüber, was der Kunde als Nächstes sieht.
Kommt Video in die KI-Antwort?
Beim Thema Video gehen die Einschätzungen auseinander. Mittelfristig gilt es vielen als ausgemacht, dass Videoinhalte in LLM-Antworten eingebunden werden. Der Einwand dagegen zielt nicht auf den Nutzen, sondern auf die Verfügbarkeit: Der relevante Bestand liegt bei YouTube, und dass OpenAI Zugang zu diesem Inventar bekommt, ist alles andere als gesetzt.
Für die Praxis gibt es dazu einen handfesten Befund, der in Tests bestätigt wurde: YouTube-Transkripte sind aktuell die einzige Videoquelle, die Sprachmodelle zuverlässig auslesen. Damit ist die Handlungsanweisung eindeutig. Wer heute Videoinhalte für KI-Sichtbarkeit nutzen will, arbeitet nicht am Video, sondern am Transkript. Ein sauber redigiertes Transkript mit den Begriffen, die deine Kunden tatsächlich verwenden, bringt dir mehr als jede weitere Produktionsrunde.
Was sollten B2B-SaaS-Teams 2026 konkret tun?
Aus der Bilanz des Jahres lassen sich drei Empfehlungen ableiten, die zusammen die Ebenen abdecken, auf denen 2026 entschieden wird: Messung, Inhalt und Methode.
Fang an zu messen, auch mit unsauberem Setup
Der Engpass ist selten das perfekte Werkzeug. Der Engpass ist, dass in vielen Teams überhaupt keine Zahl existiert, über die sich reden lässt. Solange niemand weiß, ob die eigene Marke bei den zwanzig wichtigsten Kaufprompts genannt wird oder nicht, bleibt jede Diskussion über GEO eine Diskussion über Meinungen.
Eine erste Messung über die relevanten Kaufprompts kostet wenig und schafft die Grundlage für alles Weitere. Agenturen können dafür einen kostenlosen Kurz-Check für eine Kundendomain nutzen. Wichtig ist dabei weniger die absolute Genauigkeit als die Wiederholung: Derselbe Prompt-Satz, in gleichen Abständen abgefragt, liefert dir nach drei Monaten eine Kurve. Eine einmalige Messung liefert nur eine Anekdote.
Betreib eigene Forschung und verstärke sie multimodal
Eigene Erhebungen sind der eine Inhaltstyp, den niemand umschreiben kann, ohne dich zu zitieren. Entscheidend ist aber der zweite Teil: die Verstärkung über mehrere Formate. Eine Auswertung, die nur als Blogbeitrag existiert, hat genau eine Quelle.
Dieselbe Auswertung als Beitrag, als Video mit Transkript, als Diskussion in einem Fachforum und als Grafik hat vier. Mit jeder zusätzlichen Fassung steigt die Wahrscheinlichkeit, dass ein Modell sie findet und deiner Marke zuordnet. Das ist kein Trick, sondern schlicht die Konsequenz daraus, dass Modelle aus der Häufigkeit einer Aussage auf ihre Verlässlichkeit schließen.
Lies Methodik statt Schlagzeilen
Experimentiere selbst und lerne aus den Experimenten anderer, aber im Detail statt in Schlagzeilen. Die Einschränkung trägt die eigentliche Aussage. Die Überschrift eines Experiments („Strukturierte Daten steigern Zitationen um X Prozent“) ist meist wertlos, weil Aufbau, Stichprobe und Zeitraum darüber entscheiden, ob das Ergebnis auf deinen Fall überträgt.
Wer nur die Überschriften liest, sammelt Meinungen. Wer die Methodik liest, sammelt Wissen. Praktisch heißt das: Bei jedem Fallbeispiel, das dir 2026 begegnet, zuerst nach der Stichprobengröße und dem Zeitraum suchen. Wenn beides fehlt, kannst du dir den Rest sparen.
Womit würde ich in den nächsten drei Monaten anfangen?
Falls du eine Reihenfolge brauchst: Im ersten Monat würde ich zwanzig bis dreißig Kaufprompts festlegen und sie zweimal messen, damit du eine Ausgangslage und eine erste Schwankung siehst. Parallel dazu das Freitextfeld im Lead-Formular einbauen, weil die Antworten darin erst nach Wochen aussagekräftig werden und du deshalb früh anfangen musst.
Im zweiten Monat würde ich die drei Prompts heraussuchen, bei denen Wettbewerber genannt werden und du nicht, und für jeden davon prüfen, welche Quelle das Modell dort zitiert. Meistens ist es eine Handvoll immer derselben Seiten. Im dritten Monat entsteht daraus die Arbeitsliste: eine eigene Erhebung, die eine dieser Quellen inhaltlich schlägt, und die Klärung, ob du auf den zitierten Seiten überhaupt vorkommst. Das ist unspektakulär und dauert länger als ein Hack. Es ist aber auch deutlich schwerer zu kopieren als ein Listicle.
Häufige Fragen zu diesem Thema
Lohnt sich eine llms.txt für die KI-Sichtbarkeit?
Als Sichtbarkeitshebel ist sie nicht belegt. Nützlich ist die Datei dort, wo maschinelle Konsumenten gezielt Dokumentation abrufen, also bei APIs und Coding Agents. Für eine Marke gilt die Faustregel: mitnehmen, solange sie in einer Stunde erledigt ist. Wer ein Projekt daraus macht, investiert die Zeit falsch.
Brauchen wir ein eigenes GEO-Team neben dem SEO-Team?
In den allermeisten Fällen nicht. Was eine Seite in KI-Antworten zitierfähig macht, überschneidet sich weitgehend mit dem, was sie in klassischen Trefferlisten trägt. Die praktisch wichtigere Frage ist, ob das bestehende SEO-Team zwei Tage im Monat für Antwortmaschinen freibekommt. Eine zweite Organisation daneben erzeugt vor allem Abstimmungsaufwand.
Wie viel Umsatz kommt realistisch aus KI-Suche?
Das hängt stark am Geschäftsmodell. Für B2B und Tech werden Conversion-Anteile von 4 bis 10 Prozent berichtet, im B2B-SaaS tauchen einzelne Fälle mit 10 bis 20 Prozent auf. Im B2C liegt der Anteil rein klickbasiert meist unter einem Prozent. Weil dieser Traffic am Ende der Entscheidung steht und nicht am Anfang, trägt ein einstelliger Traffic-Anteil oft einen zweistelligen Anteil an den Abschlüssen.
Wie misst man KI-Sichtbarkeit, wenn Attribution kaum funktioniert?
Über zwei Wege parallel. Erstens eine wiederholte Messung derselben Kaufprompts in festen Abständen, gelesen als Erwähnungsquote und nicht als Ranking. Zweitens self-reported Attribution, also ein Freitextfeld im Lead-Formular mit der Frage, wie jemand auf dich aufmerksam geworden ist. Beides ist ungenau. Zusammen benennen sie den Kanal trotzdem zuverlässiger als jedes Attributionsmodell.
Bringen Sie Ihre Kunden ganz nach oben in KI-Antworten.
Starten Sie noch heute mit der führenden KI-Visibility-Plattform für Agenturen. Oder lassen Sie sich die Plattform live zeigen.


